De git push a produção: o caminho completo, passo a passo
Publicado em 2026-09-12 por frfrand
Qué pasa exactamente entre que subís un commit y tu sitio se actualiza, cuáles son los tres puntos donde se rompe, y cómo leer los logs para saber cuál fue.
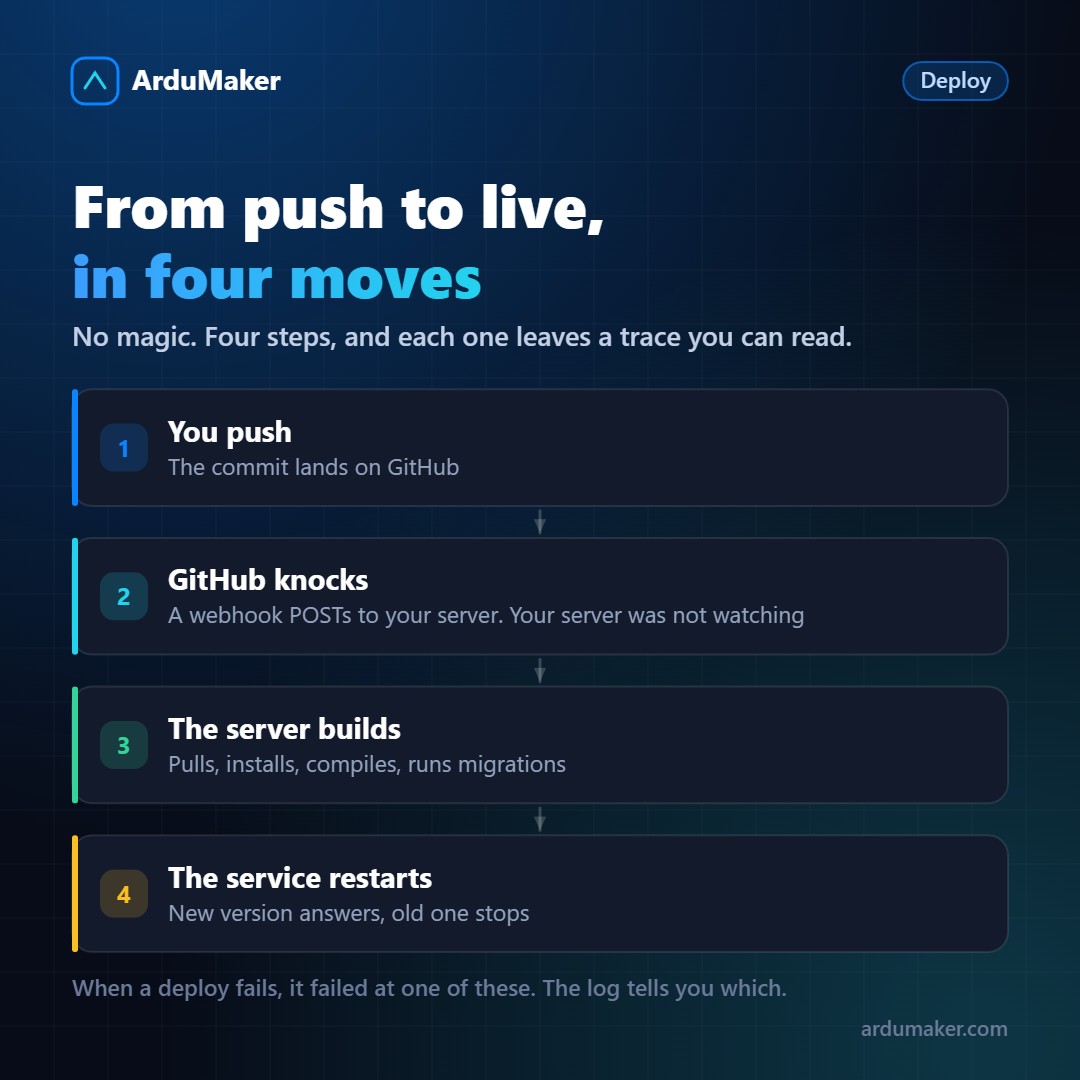
Você faz git push, espera trinta segundos e seu site está atualizado. O que acontece no meio são quatro passos bem concretos, e conhecê-los transforma "o deploy não funcionou" em um diagnóstico de dois minutos.
Passo 1: o commit chega ao repositório
Seu push envia os novos objetos para o remoto. Até aqui nada tem a ver com seu servidor.
Se o push falhou, o problema é do Git ou de permissões, e nem mesmo começou um despliegue.
Passo 2: GitHub bate à porta
Aqui está o detalhe que mais confunde quem está começando: seu servidor não verifica o GitHub de vez em quando. Seria um desperdício e chegaria tarde.
É o contrário: o GitHub envia uma requisição HTTP para um endereço seu. Isso é um webhook.
Seu servidor recebe essa mensagem, verifica se ela vem assinada com o segredo compartilhado (se não, qualquer um poderia disparar despliegues) e só aí começa a trabalhar.
Como diagnosticar este passo: o GitHub guarda o histórico de cada webhook com sua resposta. Se o despliegue não arrancou, esse histórico diz tudo. Um 404 significa que o endereço está errado. Um 500, que seu receptor falhou. Um tempo de esgotado, que o servidor não respondeu.
Este é o primeiro lugar para olhar, e o que mais vezes resolve o problema.
Passo 3: o servidor constrói
O servidor baixa o código e executa os comandos de construção do projeto:
git pull npm install && npm run build # ou pip install -r requirements.txt python manage.py migrate # se houver migrações
É o passo mais longo e o que mais falha, quase sempre por dois motivos:
- Uma dependência nova que está na sua máquina e não foi instalada no servidor.
- Memória. Compilar um frontend moderno consome bastante RAM, e em um VPS pequeno o processo pode morrer no meio do caminho. O sintoma é um log que é cortado de repente, sem erro claro. Se você vir isso, veja se o sistema matou o processo por falta de memória.
Uma decisão que vale considerar: construir no servidor é simples e não precisa de infraestrutura extra, mas consome recursos do mesmo servidor que atende os usuários. Construir fora e enviar o resultado já compilado é mais leve em produção, ao custo de mais peças.
Passo 4: o serviço é reiniciado
O novo código está no disco, mas o processo que roda continua sendo o velho, com o código anterior carregado na memória. É preciso reiniciá-lo:
systemctl restart miapp
E aqui aparece a lacuna: entre o processo velho morrer e o novo responder, passam entre dois e dez segundos onde ninguém atende. O usuário vê um 502.
Para evitá-lo, é preciso inverter a ordem: levantar a versão nova, esperar que ela responda, enviar o tráfego para ela e só então desligar a velha. Para isso, convém ter uma rota de saúde que diga "já estou pronta de verdade".
Se o seu site for estático, este passo nem existe: os novos arquivos já estão no disco e o nginx os serve.
O resumo que vale ter à mão
- Não foi disparado nada → o webhook. Confira o histórico de entregas no GitHub.
- Foi disparado e falhou → o log do build. Dependências ou memória.
- Terminou bem, mas o site continua igual → o serviço não foi reiniciado, ou há cache à frente.
- 502 logo após publicar → é o intervalo da reinicialização. Se persistir, o app não subiu: confira o log dele.
No ArduMaker, esses quatro passos são configurados uma vez pelo painel (repositório, branch, comandos, domínio) e cada implantação fica com seu log completo, então a pergunta "em qual dos quatro parou?" se responde olhando, não chutando.