Los pasos para encontrar una falla en un servidor
Publicado el 2026-09-12 por frfrand
Un método en seis pasos que evita el diagnóstico a ciegas: qué preguntar primero, en qué orden mirar, cómo descartar de a una y por qué el reinicio va al final.
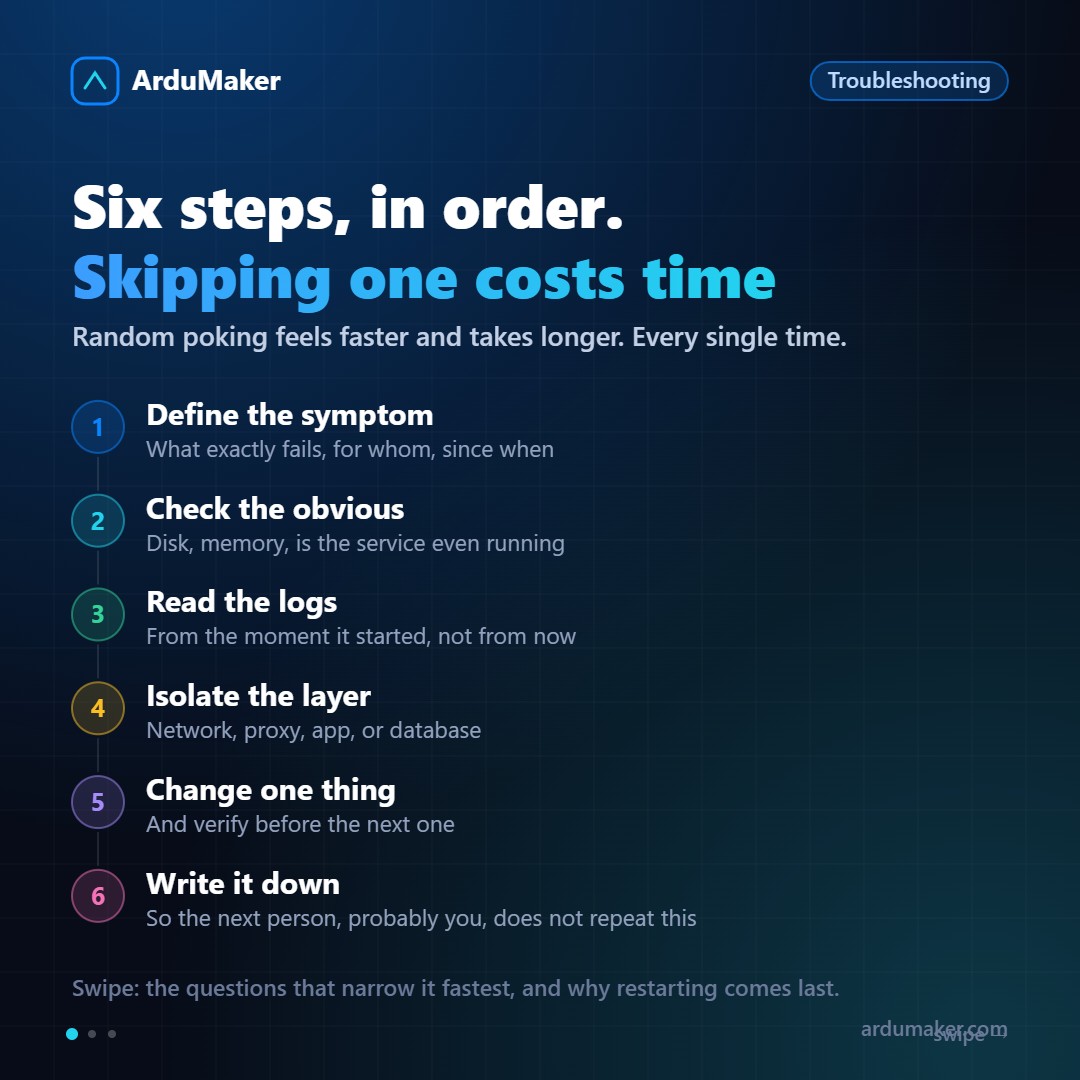
Algo no anda. La tentación es abrir cinco terminales y empezar a mirar cosas. Casi siempre eso tarda más que seguir un orden.
Este es un método que funciona.
1. Definir el síntoma con precisión
Antes de tocar nada, contesta:
- Qué falla exactamente. "El sitio no anda" no sirve. ¿Da error, tarda, muestra algo incorrecto? ¿Qué código de estado?
- Para quién. ¿Todos los usuarios o algunos? ¿Desde todas las redes?
- Desde cuándo. Y sobre todo: qué cambió alrededor de ese momento. Un despliegue, una actualización, un pico de tráfico, un certificado que venció.
Esa última pregunta resuelve más incidentes que cualquier herramienta. La enorme mayoría de las fallas en producción siguen a un cambio.
2. Lo obvio, que no siempre se mira
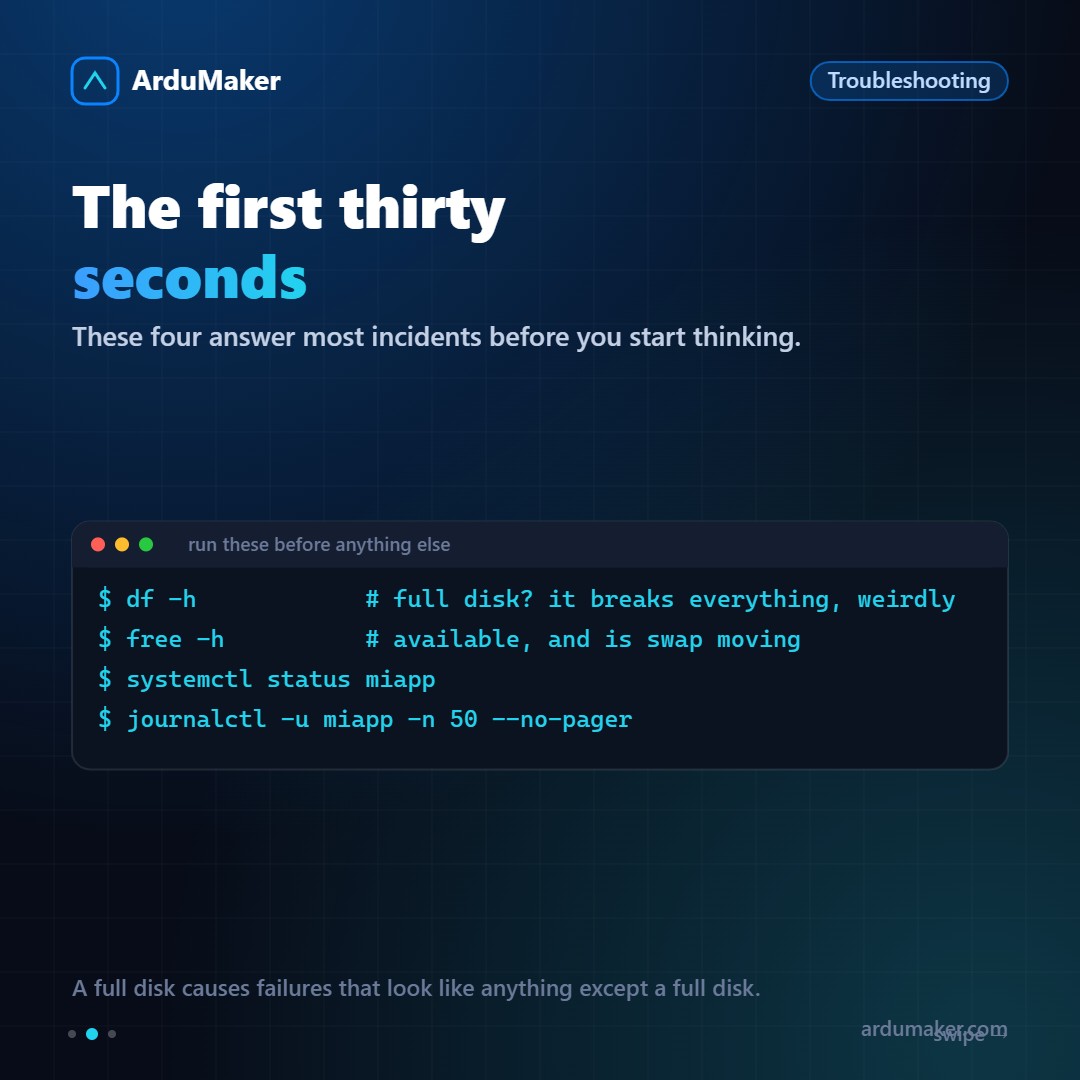
Cuatro comandos, treinta segundos:
df -h # disco lleno free -h # memoria disponible systemctl status miapp journalctl -u miapp -n 50 --no-pager
El disco lleno merece énfasis aparte. Cuando no queda espacio, las fallas que produce no se parecen en nada a "disco lleno": la base no puede escribir su registro, la aplicación no puede crear archivos temporales, los logs dejan de escribirse justo cuando más los necesitás. Se ve caótico y la causa es una sola.
Y ojo con los inodos: se pueden agotar con el disco a medias si hay muchísimos archivos chicos.
df -i
3. Leer los logs desde el principio
El error importante casi nunca es el último. Es el primero.
Cuando un sistema se rompe, produce una cascada: el fallo original genera diez errores derivados. Si mirás las últimas líneas, estás viendo las consecuencias.
journalctl -u miapp --since "14:30" --no-pager
Ir al momento en que empezó, no al momento actual.
4. Aislar la capa
Una petición atraviesa varias capas. Hay que averiguar dónde se corta, y se hace de afuera hacia adentro:
- ¿Responde el servidor? Un ping o una conexión al puerto.
- ¿Responde nginx? Pedirle algo estático.
- ¿Responde la aplicación directamente, saltando el proxy? Una petición a localhost en su puerto.
- ¿Responde la base? Conectarse y hacer una consulta trivial.
La primera que falle es donde está el problema. Ese orden evita horas de mirar la capa equivocada.
5. Un cambio por vez
Cuando encontrás la causa probable, cambiá una sola cosa y verificá.
Si cambiás tres y funciona, no sabés cuál era, no aprendiste nada, y probablemente dejaste dos cambios innecesarios que van a confundir a alguien dentro de seis meses.
6. Anotarlo
Tres líneas: qué pasaba, qué era, qué se hizo. En un archivo del servidor, en el ticket, donde sea.
El valor aparece la próxima vez, cuando alguien busque el mismo síntoma.
Sobre reiniciar
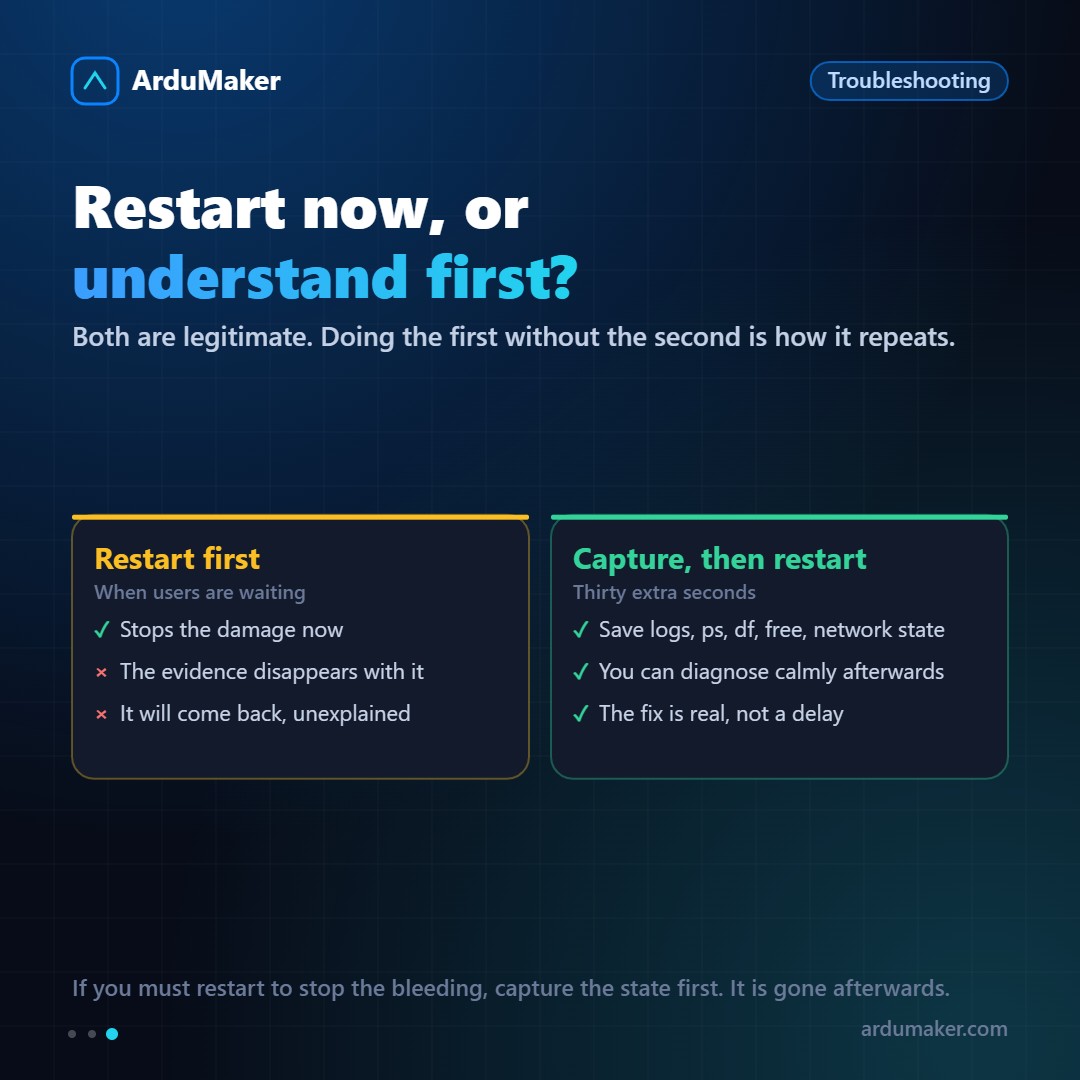
Reiniciar es legítimo cuando hay usuarios esperando: detiene el daño.
El problema es reiniciar sin capturar nada, porque con el reinicio se va la evidencia y el problema vuelve sin explicación.
Antes de reiniciar, treinta segundos:
journalctl -u miapp -n 500 > /tmp/incidente.log ps aux > /tmp/incidente-ps.txt df -h; free -h; ss -tulpn
Con eso podés reiniciar tranquilo y diagnosticar después, con calma.
Un procedimiento que puedes repetir sin improvisar
Ante un error 502 en una aplicación alojada en un VPS, no reinicies servicios al azar. Primero confirma si el DNS apunta al servidor correcto; luego revisa si Nginx responde y si puede conectarse con el proceso de la aplicación. Consulta los logs del proxy y del servicio, y comprueba los cambios de código y variables introducidos en el último despliegue.
En ArduMaker puedes usar los accesos al VPS y sus herramientas de administración para reunir esas evidencias. Registra hora, síntoma, servicio afectado, hipótesis y resultado de cada prueba: así el próximo incidente se investiga más rápido.
Relacionado: Qué es Nginx · Dónde se guardan los logs.