Por que o deploy é a parte mais importante do seu projeto
Publicado em 2026-09-12 por frfrand
El código que no está en producción no existe. Por qué un despliegue difícil deforma todo lo demás, qué significa que sea aburrido y cómo se llega ahí.
Há uma frase incômoda e bastante verdadeira: o código que não está em produção não existe. Não importa o quão bem escrito esteja, não importa que passe em todos os testes. Até que alguém o use, é uma intenção.
Por isso, o mecanismo que leva seu código da sua máquina até o usuário merece mais atenção do que costuma receber.
O círculo vicioso
O interessante de um deploy difícil é que não só faz você perder tempo: deforma a forma como a equipe trabalha.
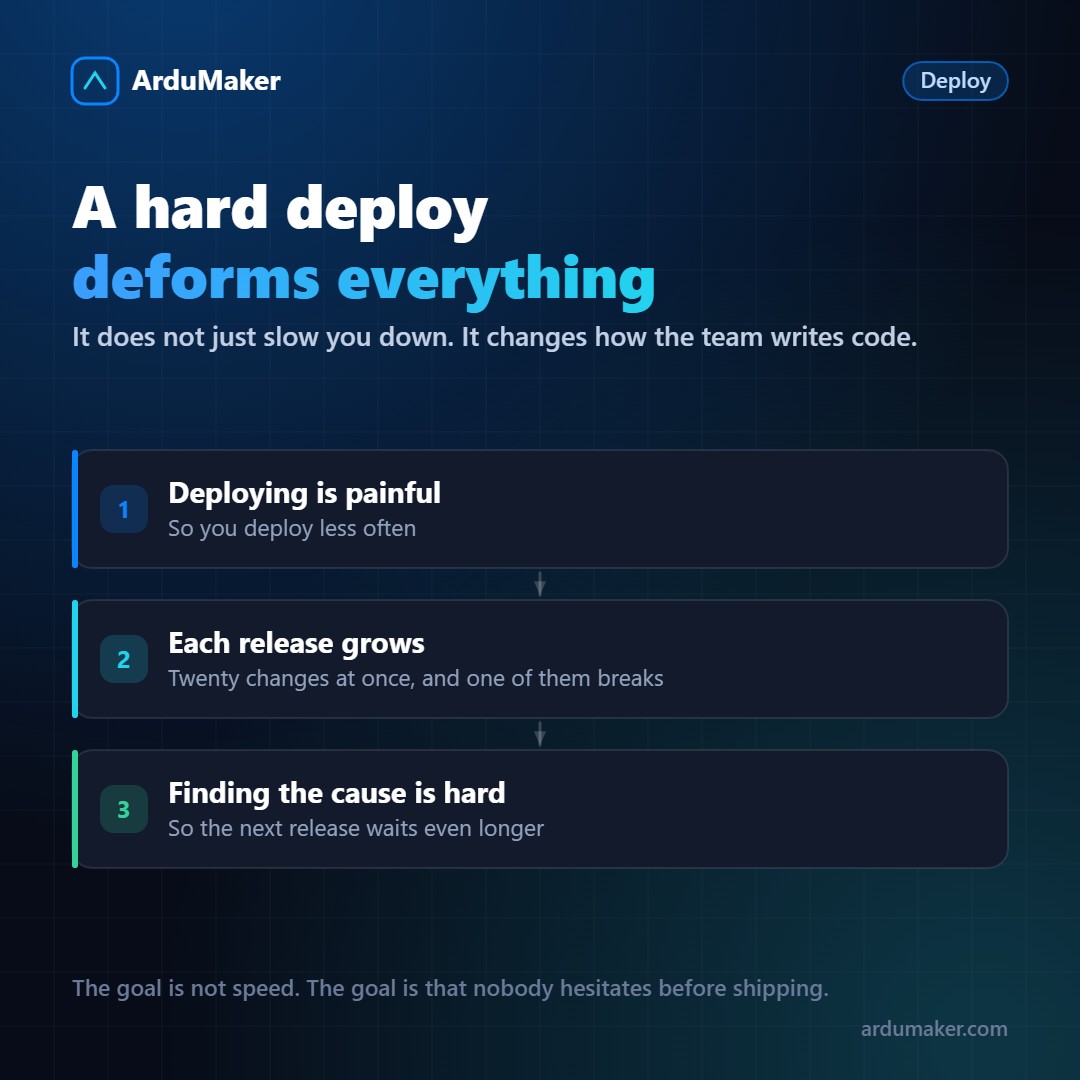
Se publicar é caro, se publica com menos frequência. Se se publica com menos frequência, cada entrega acumula mais mudanças. Se cada entrega tem vinte mudanças e algo quebra, encontrar qual foi leva muito mais tempo. E como a última entrega foi traumática, a seguinte é adiada.
É um círculo que se retroalimenta, e quase sempre é diagnosticado errado: se culpa o código, a falta de testes ou a equipe, quando o problema estava na fricção de publicar.
O corolário é contraintuitivo: publicar com mais frequência costuma ser mais seguro, não menos. Um deploy de três mudanças é fácil de reverter e rápido de diagnosticar.
O que significa que seja chato
Um bom deploy tem quatro propriedades, e nenhuma tem a ver com velocidade:
Automático. Ninguém executa passos manualmente. Passos manuais são esquecidos, especialmente na sexta-feira às sete.
Repetível. O mesmo commit produz o mesmo resultado. Se o deploy depende do que estava instalado no servidor naquele dia, não é repetível.
Observable. Quando falha, o log diz em qual passo. Um deploy que falha silenciosamente é pior do que um que não existe.
Reversível. Você tem que conseguir voltar para a versão anterior em minutos, sem pensar. E isso se testa antes de precisar.
Os três passos que sempre estão
Debaixo de qualquer ferramenta, um deploy web faz a mesma coisa:
- Trazer o código novo para o servidor.
- Construir: instalar dependências, compilar, aplicar migrações.
- Reiniciar o serviço para que ele pegue a versão nova.
Quando algo falha, falha em uma dessas três junções. Saber isso encurta muito o diagnóstico. E quase sempre é a terceira, o reinício: o serviço não subiu, ou subiu com a configuração antiga.
O buraco do reinício
Entre desligar o processo antigo e o novo responder, há alguns segundos em que ninguém atende. O usuário vê um erro 502.
A forma de evitar isso é inverter a ordem: subir a versão nova, esperar que ela responda, enviar o tráfego para ela e só então desligar a antiga. Para isso serve ter um endpoint de saúde que diga "já estou pronta de verdade", e não apenas "o processo existe".
O mais difícil não é o código
Voltar atrás no código é fácil: reverter o commit e fazer deploy.
O banco de dados é outra coisa. Uma migração que apagou uma coluna não se desfaz com um redeploy.
Por isso convém a ordem: primeiro adicionar o novo, depois que o código o use, e apagar o velho apenas vários dias depois, quando já estiver seguro. Assim, sempre existe uma versão anterior do código que continua funcionando com o banco de dados atual.
Aonde chegar
A meta não é ter o deploy mais rápido. É que ninguém duvide antes de publicar.
Quando publicar é chato, a equipe entrega em pedaços pequenos, os erros se encontram sozinhos e o tempo é gasto no produto e não na cerimônia.
No ArduMaker esse caminho se configura uma vez pelo painel: repositório, branch, comandos de build e domínio. Cada push executa os três passos e deixa seu log, então quando algo quebra, vê-se exatamente em qual.