O que é um repositório remoto e por que existe
Publicado em 2026-09-12 por frfrand
Un remoto no es "la nube": es otra copia del repositorio a la que le pusiste un nombre. Qué hacen fetch, pull y push en realidad, y por qué conviene separar traer de integrar.
Um repositório remoto soa como "o repositório na nuvem". É uma descrição conveniente e enganosa.
Um remoto é simplesmente outra cópia do repositório, em outro lugar, à qual você deu um nome curto para não precisar digitar o endereço toda vez.
$ git remote -v origin git@github.com:empresa/app.git (fetch) origin git@github.com:empresa/app.git (push)
"origin" não tem nada de especial. É o nome padrão do primeiro que você configura. Poderia se chamar "github", "central" ou "pepe".
Por que é necessário, se o Git é distribuído
Tecnicamente não é necessário. Duas pessoas poderiam fazer pull diretamente uma da máquina da outra. O Git suporta isso.
Na prática não funciona: os computadores desligam, mudam de rede, estão atrás de roteadores. Então a equipe concorda em um local que está sempre disponível, e esse local se torna o ponto de encontro.
A diferença com os sistemas centralizados de antes é sutil, mas importante: esse servidor é uma convenção, não uma necessidade técnica. Sua cópia não é mais "verdadeira" do que a sua; simplesmente está sempre ligada.
Três comandos, e um que confunde
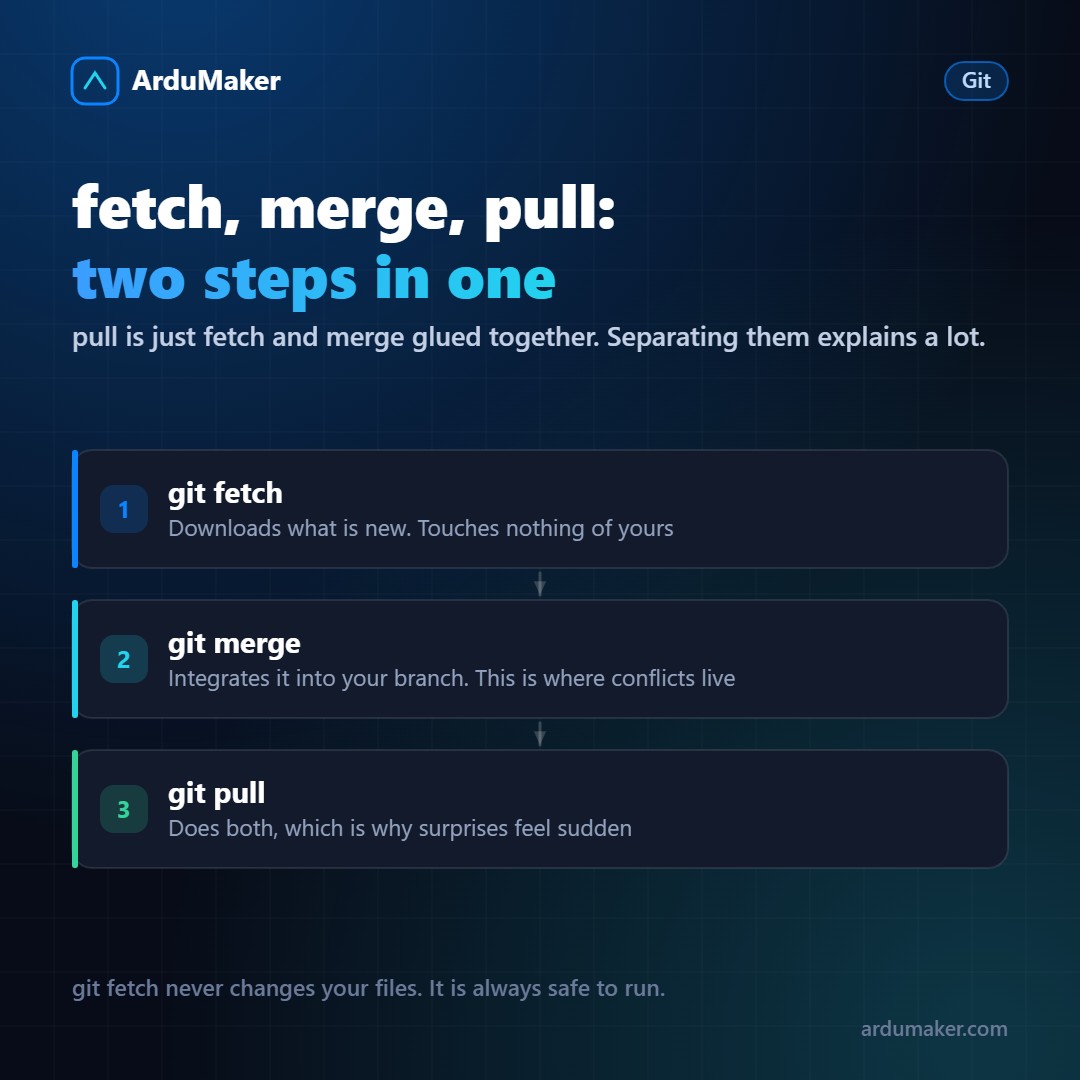
git fetch baixa o que há de novo no remoto e o guarda à parte, em referências como origin/main. Não toca nos seus arquivos nem no seu branch. É sempre seguro de executar, e é a resposta correta para "o que há de novo?".
git merge origin/main integra isso ao seu branch atual. É aqui que podem aparecer conflitos.
git pull faz as duas coisas, uma após a outra.
Essa fusão de etapas é a causa de uma sensação muito comum: que os conflitos "aparecem de repente". Não aparecem de repente; o que acontece é que o pull fez duas coisas e você viu apenas a segunda.
Um costume que vale a pena, sobretudo em equipes ativas:
git fetch git log --oneline HEAD..origin/main # o que veio git merge origin/main # agora sim
Três comandos em vez de um, e nenhuma surpresa.
push, e por que às vezes ele é rejeitado
git push envia seus commits ao remoto. O remoto aceita somente se o seu histórico contém o dele: ou seja, se você puder avançar sem perder nada.
Se alguém enviou algo que você não tem, o push é rejeitado. Não é um erro: é uma proteção. Se fosse aceito, os commits dessa pessoa ficariam órfãos.
A solução correta é trazer o novo, integrar e voltar a empurrar.
E a solução incorreta, que aparece em muitas respostas da Internet:
git push --force
Isso substitui o histórico do remoto pelo seu, e o trabalho da outra pessoa desaparece do remoto. Se realmente for necessário forçar (por exemplo, depois de reescrever sua própria ramificação), existe uma variante muito mais segura:
git push --force-with-lease
Essa falha se o remoto mudou desde a última vez que você olhou, em vez de pisar às cegas.
Vários remotos ao mesmo tempo
Nada o obriga a ter apenas um:
git remote add upstream git@github.com:original/projeto.git git fetch upstream
É o fluxo clássico quando você trabalha em um fork: origin é sua cópia, upstream é o projeto original, e você traz de um e empurra para o outro.
Você também pode ter um remoto que seja seu próprio servidor e fazer o deploy com um push direto.
Uma recomendação curta
Configure o remoto por SSH e não por HTTPS. Com SSH, você usa sua chave, não digita senhas nem tokens, e funciona da mesma forma na sua máquina e em um servidor de integração.
Se já estiver usando HTTPS:
git remote set-url origin git@github.com:empresa/app.git