Por que existem os branches e os merges
Publicado em 2026-09-12 por frfrand
Una rama es un puntero de 41 bytes, y eso explica por qué Git cambió la forma de trabajar en equipo. Qué es realmente un conflicto, y la diferencia entre merge y rebase sin religión.
Antes do Git, criar um branch era uma operação. Em alguns sistemas implicava copiar o projeto inteiro no servidor e podia demorar minutos. A consequência cultural foi que quase ninguém ramificava: se trabalhava tudo no tronco e se rezava.
O Git mudou isso por uma decisão de design muito simples.
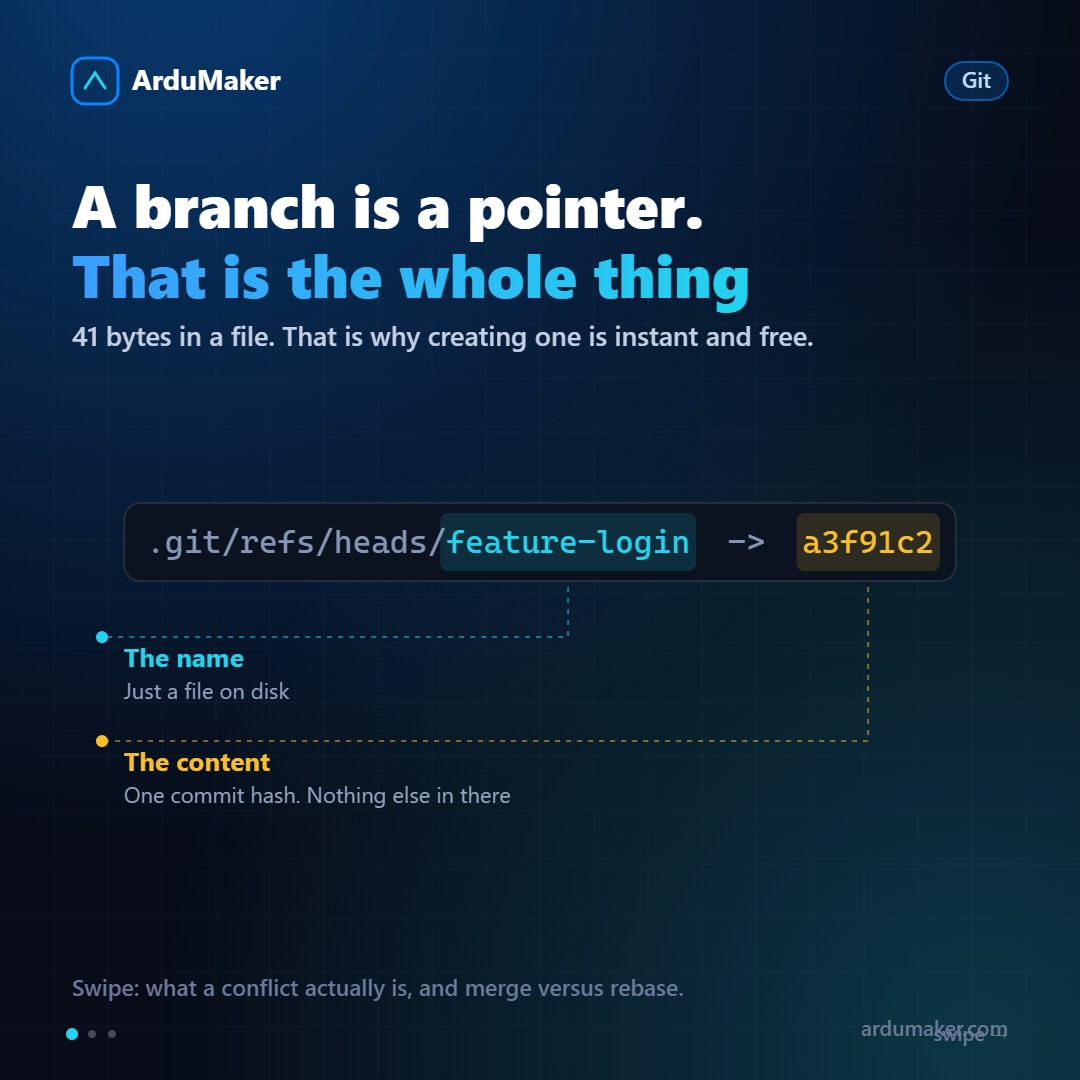
Um branch é um ponteiro
Literalmente:
$ cat .git/refs/heads/feature-login a3f91c2e8d4b7a6f9c1e2d3b4a5f6e7d8c9b0a1f
Isso é o branch inteiro. Um arquivo com um hash dentro. 41 bytes.
Criar um branch é escrever esse arquivo. Por isso é instantâneo, por isso não ocupa espaço, e por isso o fluxo de trabalho do Git te empurra a criar um para cada coisa.
Quando você faz um commit estando nesse branch, o arquivo é atualizado com o novo hash. O branch "avança". Nada mais.
O que é realmente um conflito
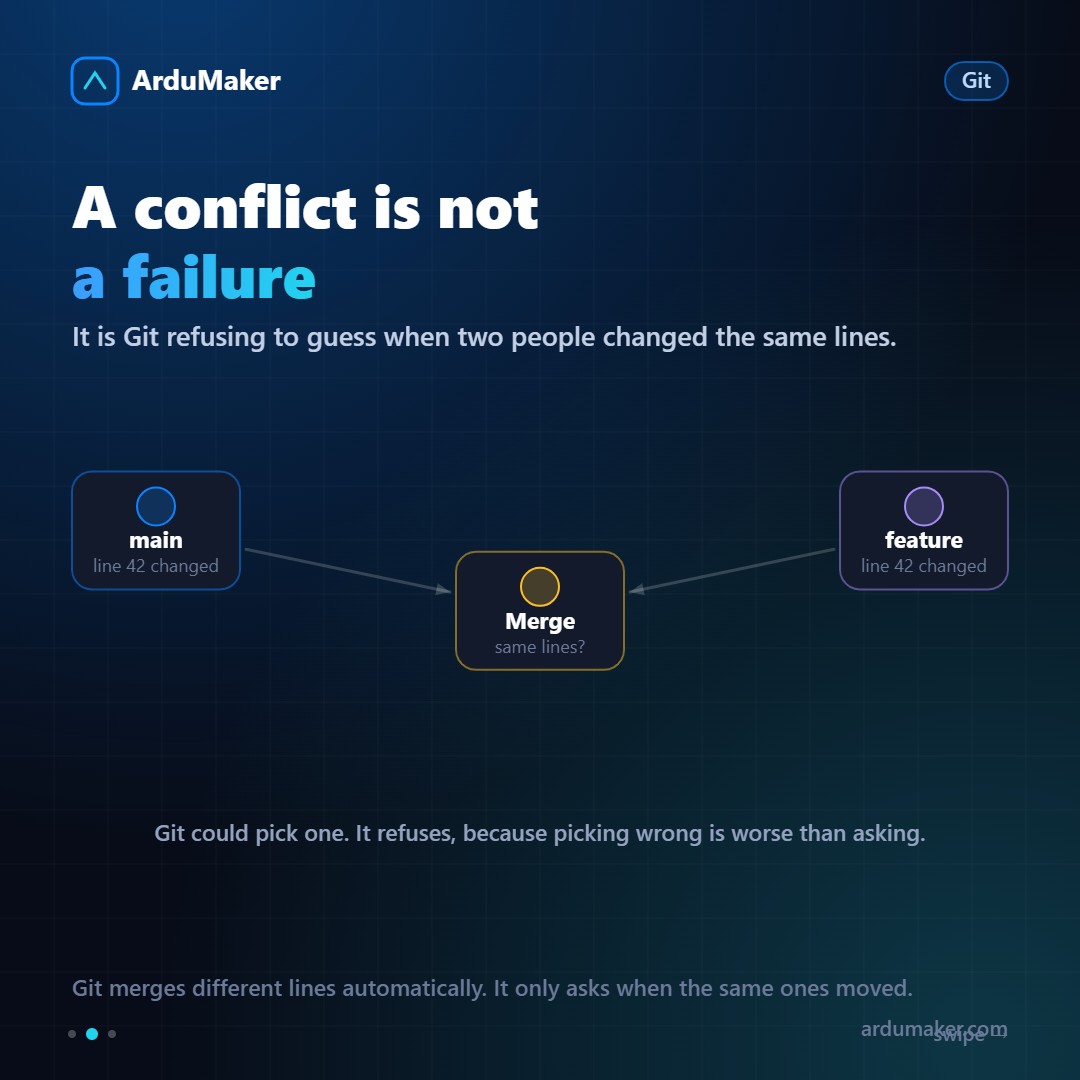
Há uma ideia equivocada muito difundida: que um conflito significa que o Git não conseguiu fazer o merge.
O Git faz merge automaticamente de quase tudo. Se você tocou no arquivo A e outra pessoa tocou no arquivo B, não há nada a decidir. Se ambos tocaram no mesmo arquivo, mas em partes diferentes, também não.
Um conflito aparece apenas quando duas pessoas alteraram as mesmas linhas de forma diferente. Aí o Git poderia escolher uma, e se recusa, porque escolher errado é pior do que perguntar.
Ver um conflito não é uma falha do processo: é a ferramenta avisando que há uma decisão humana pendente. Equipes que têm conflitos o tempo todo não têm um problema de Git: têm branches que vivem demais e tocam as mesmas coisas.
Merge e rebase, sem religião
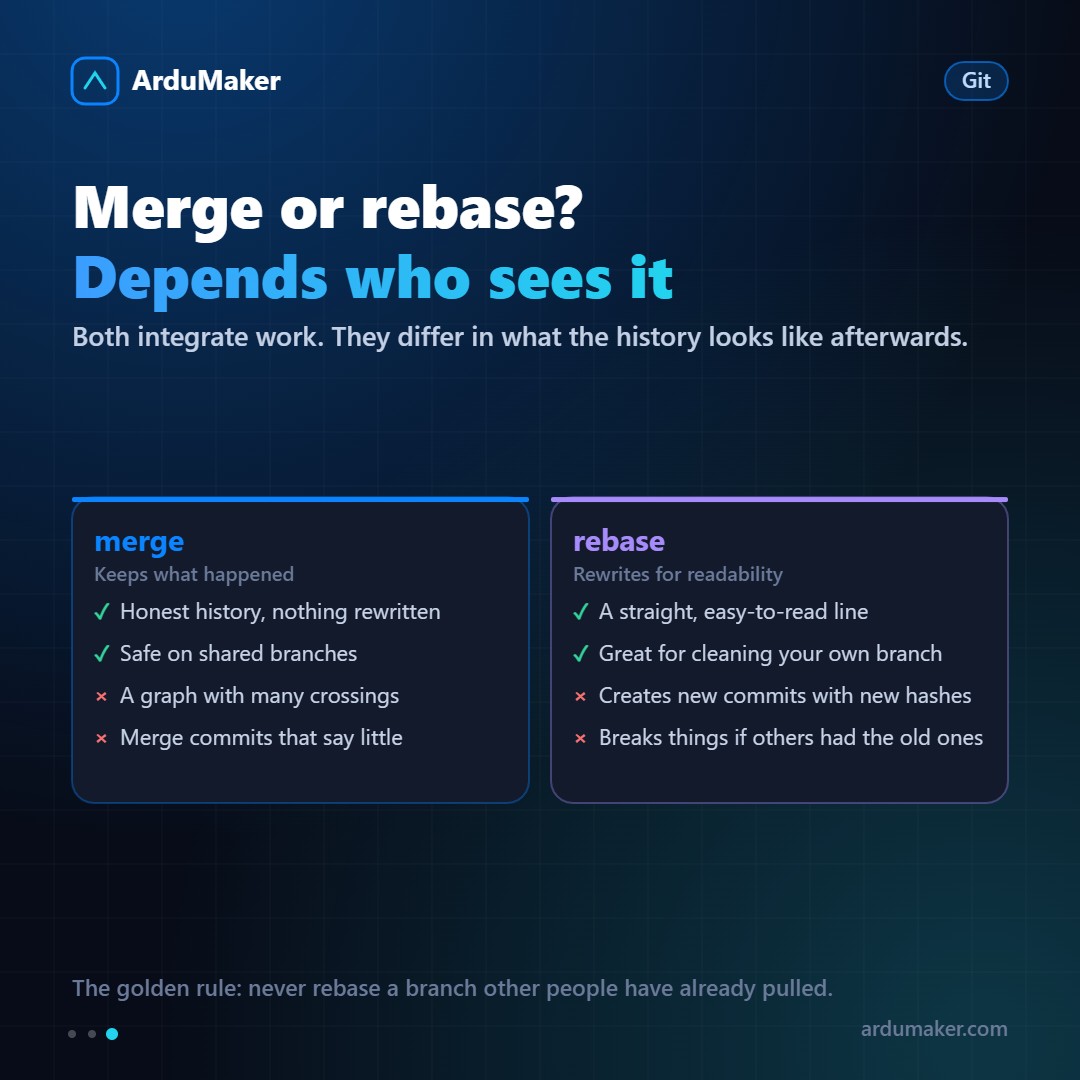
As duas integram o trabalho de uma branch em outra. Diferenciam-se no que fica escrito depois.
merge cria um novo commit com dois pais. O histórico fica como aconteceu: duas linhas que se separaram e se juntaram. É honesto e não reescreve nada.
rebase pega seus commits e os reaplica em cima da outra branch, como se você os tivesse feito depois. O histórico fica em linha reta e lê melhor. Mas são commits novos, com hashes novos: os originais ficam órfãos.
Daí sai a única regra que realmente importa:
Não faça rebase em uma branch que outras pessoas já tenham. As cópias delas continuam apontando para os commits antigos, e ao tentar integrar vão aparecer duplicatas e confusão.
Sobre sua própria branch, antes de compartilhá-la, o rebase é excelente: permite limpar commits intermediários do tipo "correção", "agora sim" e "volto atrás".
Uma combinação que funciona muito bem em equipes: rebase para organizar sua branch antes de abrir o pull request, merge para integrá-la.
A parte que mais ajuda e menos se diz
Quase todos os problemas com branches se resolvem antes de existirem, com um costume: branches curtas.
Um ramo de dois dias toca pouco, se integra sem drama e quase nunca gera conflitos. Um ramo de três semanas se torna um projeto de integração em si mesmo.
Se uma tarefa é grande, a resposta não é um ramo longo: é dividir a tarefa em pedaços que possam ser integrados separadamente, mesmo que fiquem atrás de um interruptor desligado.