O que é o PostgreSQL e por que se tornou o padrão
Publicado em 2026-09-12 por frfrand
De proyecto universitario a la base relacional que casi todo el mundo elige. Qué la hizo ganar, qué trae de fábrica que sorprende, y los dos ajustes que casi nadie toca y debería.
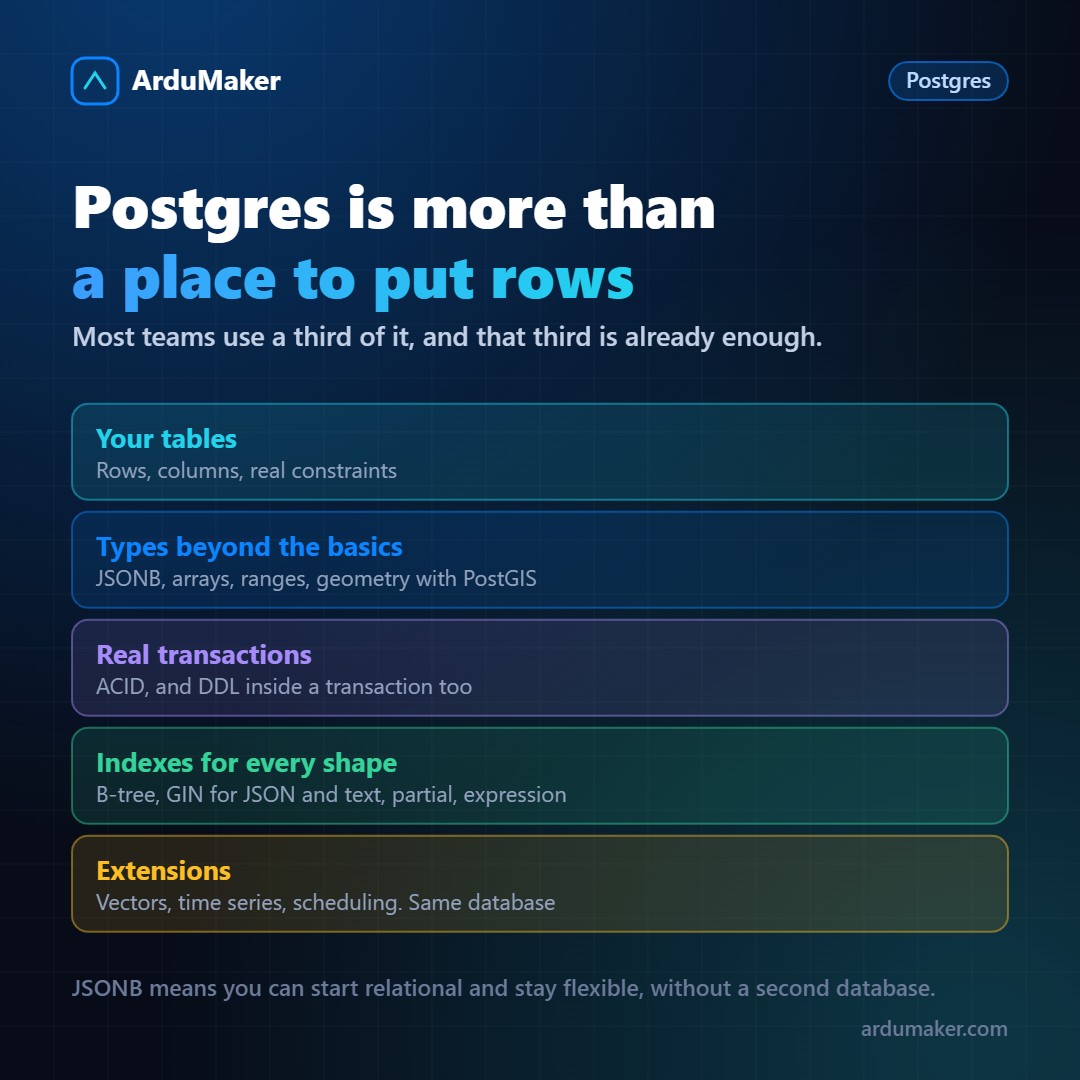
PostgreSQL começou nos anos oitenta em Berkeley como sucessor de um projeto chamado Ingres. Durante décadas foi "a outra", a alternativa séria, mas menos popular que o MySQL.
Nos últimos dez anos, tornou-se a opção padrão para novos projetos. Vale a pena entender por quê, porque as razões são concretas.
O que a fez vencer
Correção antes de velocidade. O Postgres sempre priorizou se comportar bem nos casos difíceis: transações que são realmente atômicas, restrições que são cumpridas, tipos que não aceitam dados inválidos. Historicamente, isso a tornava mais lenta em testes simples e muito mais confiável em produção.
Um exemplo que ilustra a filosofia: se você tentar salvar um texto mais longo que a coluna, o Postgres retorna um erro. Outros motores, durante anos, truncavam silenciosamente. Um erro é incômodo; um dado mutilado que você descobre seis meses depois é pior.
DDL transacional. Você pode colocar várias mudanças de esquema em uma transação e reverter todas se algo falhar. Para migrações, isso é enorme: uma migração parcialmente aplicada é uma das piores situações possíveis, e com o Postgres isso simplesmente não acontece.
Extensível por design. É possível adicionar tipos, funções e índices sem tocar no motor. De lá surgiram o PostGIS para dados geográficos, o TimescaleDB para séries temporais, o pgvector para buscas por similaridade. A mesma base serve para coisas que antes exigiam um sistema separado.
O que traz e muita gente não usa
JSONB. Armazena JSON em formato binário, indexável e consultável. Permite começar com um esquema relacional bem definido e ter algumas colunas flexíveis onde for necessário, sem adicionar um banco de documentos ao projeto.
Arrays e intervalos. Uma coluna pode ser uma lista. Ou um intervalo de datas, com operadores para perguntar se dois intervalos se sobrepõem — perfeito para reservas, e resolvido sem lógica na aplicação.
Índices para cada forma de buscar. Além do clássico, há índices GIN para JSON e texto, índices parciais (que cobrem apenas as linhas que atendem a uma condição e ocupam muito menos espaço) e índices sobre expressões.
Visualizações materializadas. Uma consulta pesada que é salva como tabela e atualizada quando você decidir. Resolve muitos painéis de métricas sem adicionar infraestrutura.
Os dois ajustes que quase ninguém mexe
A configuração padrão do Postgres é conservadora: é pensada para iniciar em qualquer máquina, mesmo uma bem pequena. Em um servidor real, dois parâmetros fazem muita diferença:
shared_buffers. Quanta memória ele usa para o cache. O valor padrão costuma ser 128 MB. A recomendação habitual é cerca de 25% da RAM do servidor.
work_mem. Memória por operação de ordenação ou agrupamento. Se for muito pequena, essas operações são feitas em disco e as consultas ficam lentas. Atenção: ela se multiplica por operação e por conexão, então aumentá-la muito com muitas conexões pode esgotar a memória.
E o diagnóstico de sempre: colocar EXPLAIN ANALYZE à frente da consulta lenta. Se a primeira linha disser Seq Scan sobre uma tabela grande, falta um índice.
Um aviso sobre conexões
Cada conexão ao Postgres é um processo do sistema operacional. Isso o torna muito robusto (um processo que morre não leva os outros consigo) e também significa que as conexões são caras.
Um aplicativo com muitos trabalhadores pode esgotar o limite rapidamente. A solução não é aumentar o limite: é colocar um pool de conexões na frente, como PgBouncer. É o ajuste que mais vezes salva um aplicativo que "começou a falhar quando o tráfego cresceu".
No ArduMaker você pode levantar o Postgres no seu VPS a partir do painel, com credenciais, backups e acesso por túnel em vez de porta aberta.