Por que existem tantos tipos de bancos de dados
Publicado em 2026-09-12 por frfrand
No es moda: cada familia optimiza algo distinto y paga por ello en otro lado. Relacionales, documentos, clave-valor, columnares, grafos y series temporales, con el caso donde cada una gana.
Há vinte anos a resposta era uma só: banco relacional. Hoje há dezenas de opções e a escolha gera discussões inteiras.
A razão não é moda. É que cada família de bancos otimiza algo diferente, e paga por isso em outro lugar. Conhecer o trade-off de cada uma transforma a discussão em uma decisão.
Relacionais
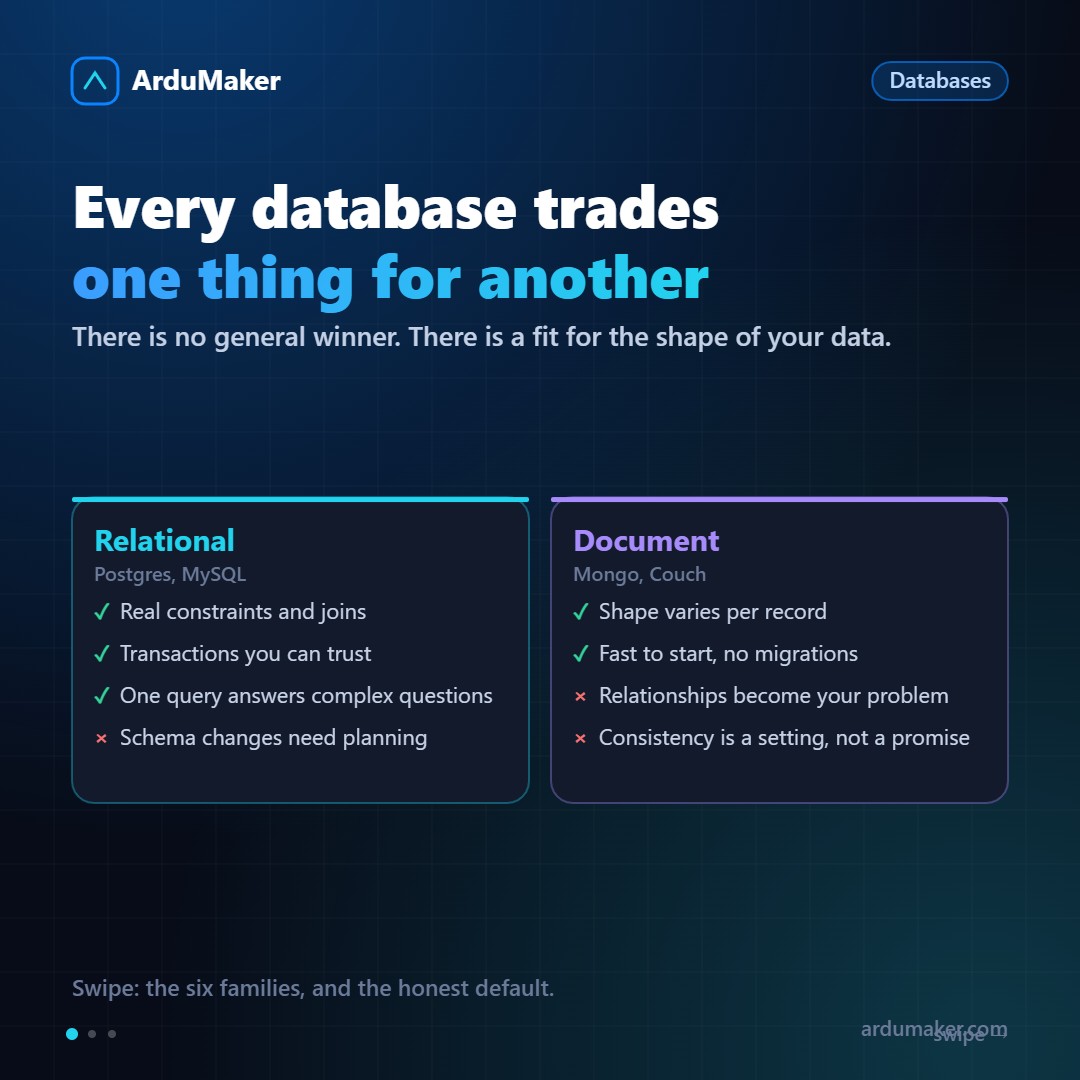
Dados em tabelas com relações explícitas. Postgres, MySQL, SQLite.
Otimizam: integridade e consultas complexas. Você pode perguntar "todos os clientes que compraram mais de três vezes no mês passado e não voltaram" em uma única consulta, e confiar no resultado.
Pagam: o esquema é rígido. Alterá-lo requer uma migração planejada.
De documentos
Armazenam objetos completos, tipo JSON. MongoDB, CouchDB.
Otimizam: flexibilidade de forma. Cada registro pode ter campos diferentes, e não há migração para adicionar um.
Pagam: as relações passam a ser seu problema. Sem joins reais, você acaba fazendo várias consultas e unindo na aplicação, ou duplicando dados e mantendo-os sincronizados manualmente.
Uma observação honesta: muitas pessoas escolheram documentos pela flexibilidade e acabaram implementando manualmente o que um banco relacional já fazia. E hoje o Postgres armazena JSON indexável, o que apagou boa parte da vantagem.
Chave-valor
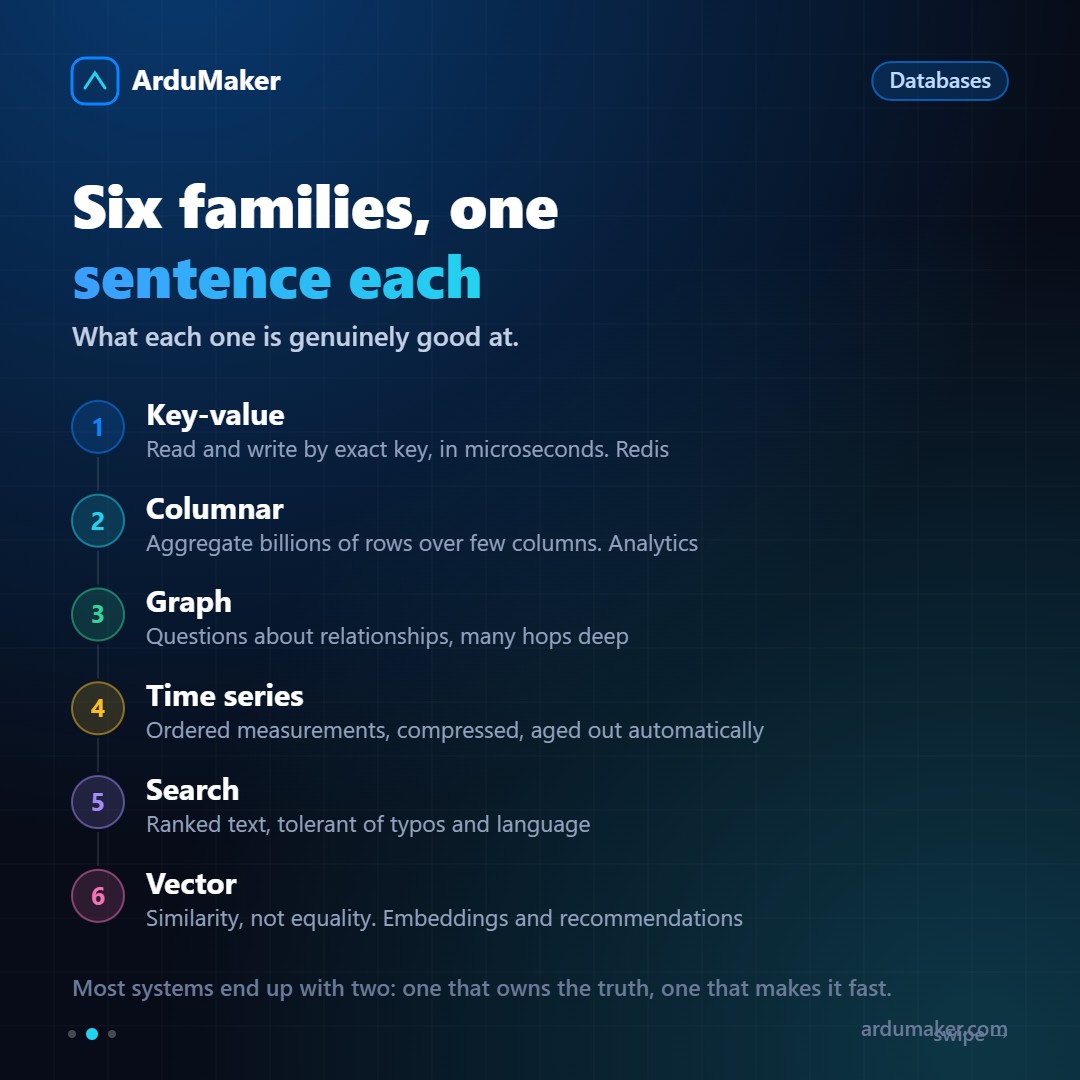
Uma chave, um valor, acesso direto. Redis, Memcached.
Otimizam: velocidade. Leituras e gravações em microssegundos, porque vivem na memória.
Pagão: não há consultas. Só é possível buscar pela chave exata. E se for apenas memória, uma reinicialização apaga tudo (o Redis pode persistir, mas esse não é o seu ponto forte).
É usado quase sempre ao lado de outro banco, não no lugar dele: cache, sessões, filas, contadores, limites de requisições.
Colunares
Armazenam por coluna em vez de por linha. ClickHouse, BigQuery.
Otimizam: agregações sobre muitas linhas. "Média de vendas por região nos últimos três anos" sobre bilhões de registros, em segundos, porque leem apenas as colunas necessárias.
Pagam: são ruins para trabalho transacional. Buscar uma linha completa ou atualizar um registro é caro.
De grafos
Nós e relacionamentos como cidadãos de primeira classe. Neo4j.
Otimizam: perguntas sobre relacionamentos em vários saltos. "Amigos de amigos que trabalharam na mesma empresa" é natural aqui e horrível em SQL.
Pagam: tudo o mais. São especializadas.
Séries temporais e busca
Séries temporais (InfluxDB, TimescaleDB): medições ordenadas por tempo, comprimidas, com exclusão automática de dados antigos. Métricas e sensores.
Busca (Elasticsearch, OpenSearch): texto com relevância, tolerância a erros de digitação, análise por idioma. Um LIKE do SQL não se compara.
O padrão honesto
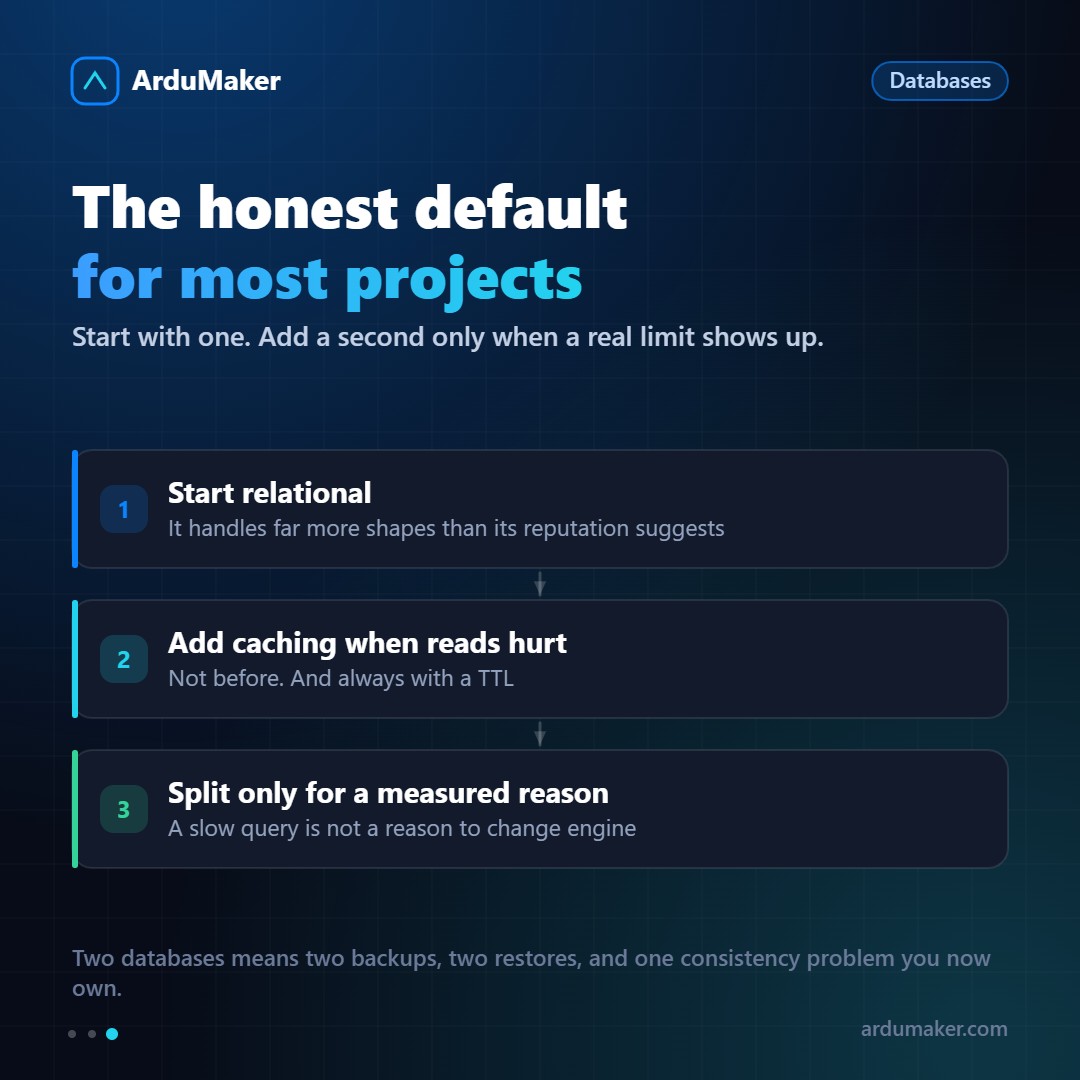
Para a maioria dos projetos: comece com um banco relacional. Ele lida com muito mais formas de dados do que sua fama sugere, e resolve integridade e consultas complexas que depois é caríssimo reimplementar.
Adicione um segundo apenas quando aparecer um limite medido. E tenha presente o custo real: dois bancos são dois backups, duas restaurações para testar, e um problema de consistência entre ambos que agora é seu.
O padrão mais comum e mais saudável é: um banco relacional que guarda a verdade, e Redis na frente para o que se lê muito.