Como se mede o trabalho de um servidor sem enlouquecer
Publicado em 2026-09-12 por frfrand
Cuatro números que dicen casi todo, qué significa realmente el load average, por qué el uso de CPU engaña, y en qué orden mirar cuando algo va lento.
Um servidor está lento. Você abre quatro ferramentas, vê números, e não fica claro qual olhar. O problema não é a falta de dados: é a ordem.
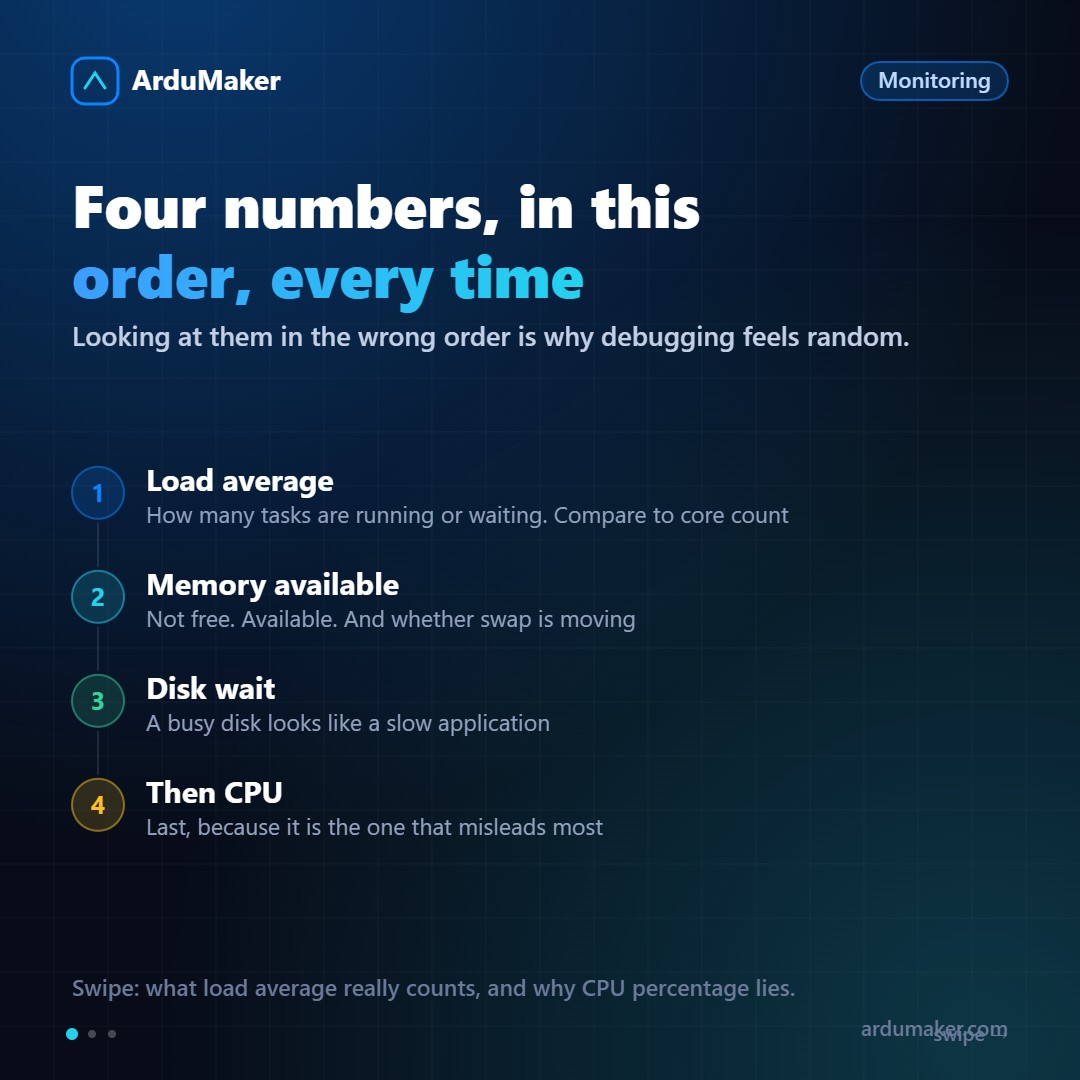
Estes são os quatro números, na ordem em que convém lê-los.
1. A média de carga (load average)
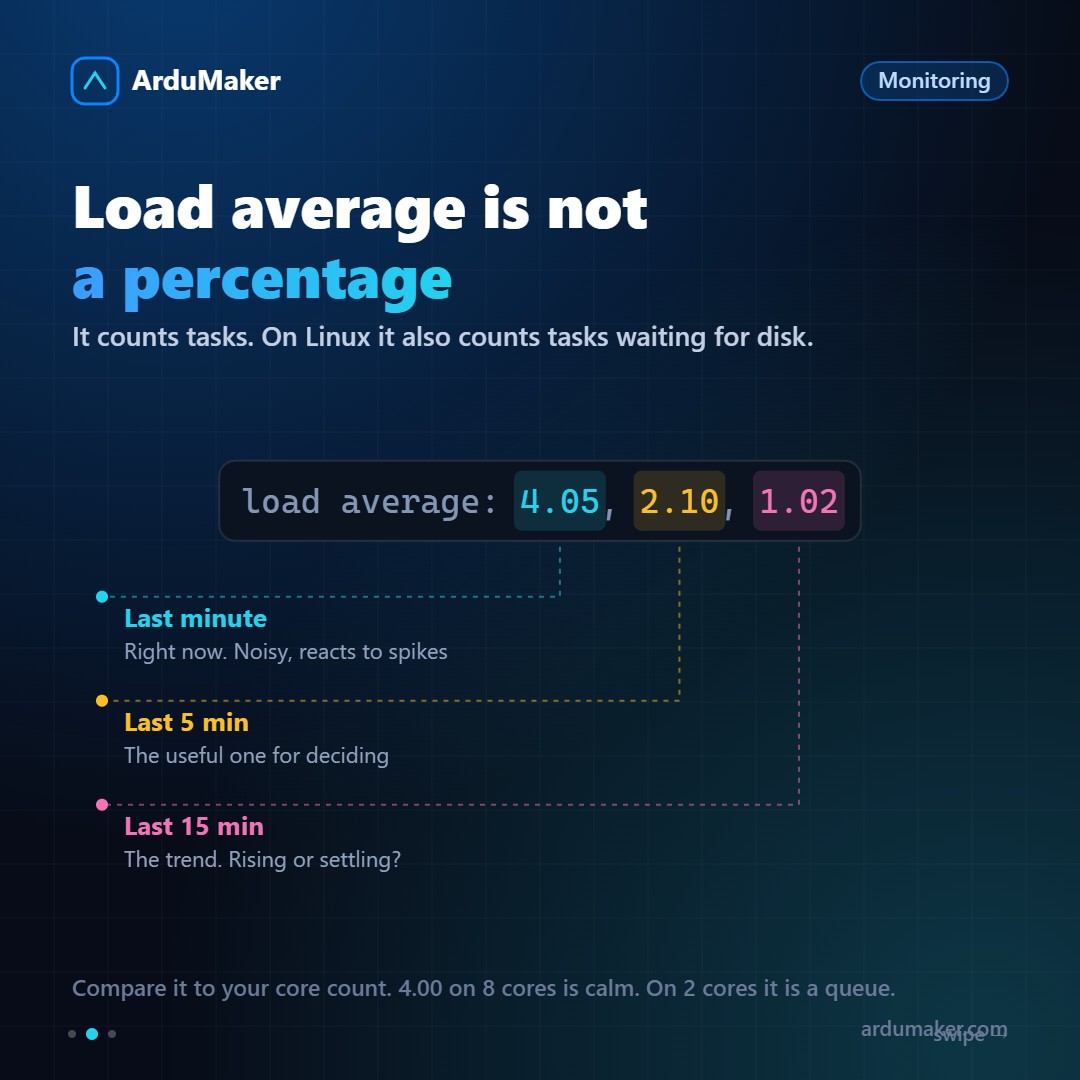
$ uptime load average: 4.05, 2.10, 1.02
Os três valores são a média do último minuto, dos últimos cinco e dos últimos quinze.
O primeiro: não é uma porcentagem. Conta tarefas que estão executando ou esperando a vez. Um valor de 4 significa "há quatro tarefas querendo rodar em média".
Para interpretá-lo, é preciso compará-lo com a quantidade de núcleos:
- 4.00 em uma máquina de 8 núcleos: tranquila, sobra capacidade.
- 4.00 em uma máquina de 2 núcleos: há fila, as tarefas esperam.
E uma particularidade do Linux que confunde muita gente: também conta as tarefas esperando pelo disco. Por isso um servidor com disco saturado pode mostrar carga altíssima com o processador quase ocioso. Não é um erro de medição: descreve corretamente que há trabalho travado.
Os três números juntos contam uma história: se o de um minuto for muito maior que o de quinze, algo acabou de começar. Se for o contrário, já está baixando.
2. A memória
$ free -h
A coluna a olhar é available, não "free".
Que "free" esteja baixo é normal e bom: o Linux usa a memória sobrante como cache de disco, e a libera quando alguém precisa. Um servidor com muita memória "livre" está desperdiçando-a.
O que realmente importa: se "available" está baixo e a swap tem movimento. Isso se vê com:
$ vmstat 1
As colunas "si" e "so" (entrada e saída de swap). Se houver atividade constante ali, o servidor está passando dados para o disco porque não cabe na memória, e a latência se multiplica por mil.
3. O disco
$ iostat -x 1
Duas coisas: a porcentagem de utilização e o tempo de espera. Um disco a 100% com esperas altas é o gargalo, e se vê de fora como "o aplicativo está lento".
Este é o número que mais se ignora, e o que mais vezes acaba sendo a causa.
4. O processador, por último
$ top
Deixa para o final porque é o que mais engana.
Um servidor a 100% de CPU pode estar perfeitamente bem: está usando o que você pagou. E um servidor a 20% pode estar arrastando, porque está esperando disco ou rede.
Dentro do top, a coluna que mais informação dá é "wa" (tempo de espera de entrada/saída). Se for alta, o processador está esperando o disco: o problema não é o processador.
E "st" (tempo roubado): o hipervisor está dando seus turnos para outro. Se for alta e consistente, você está competindo com vizinhos.
O número que quase ninguém mede
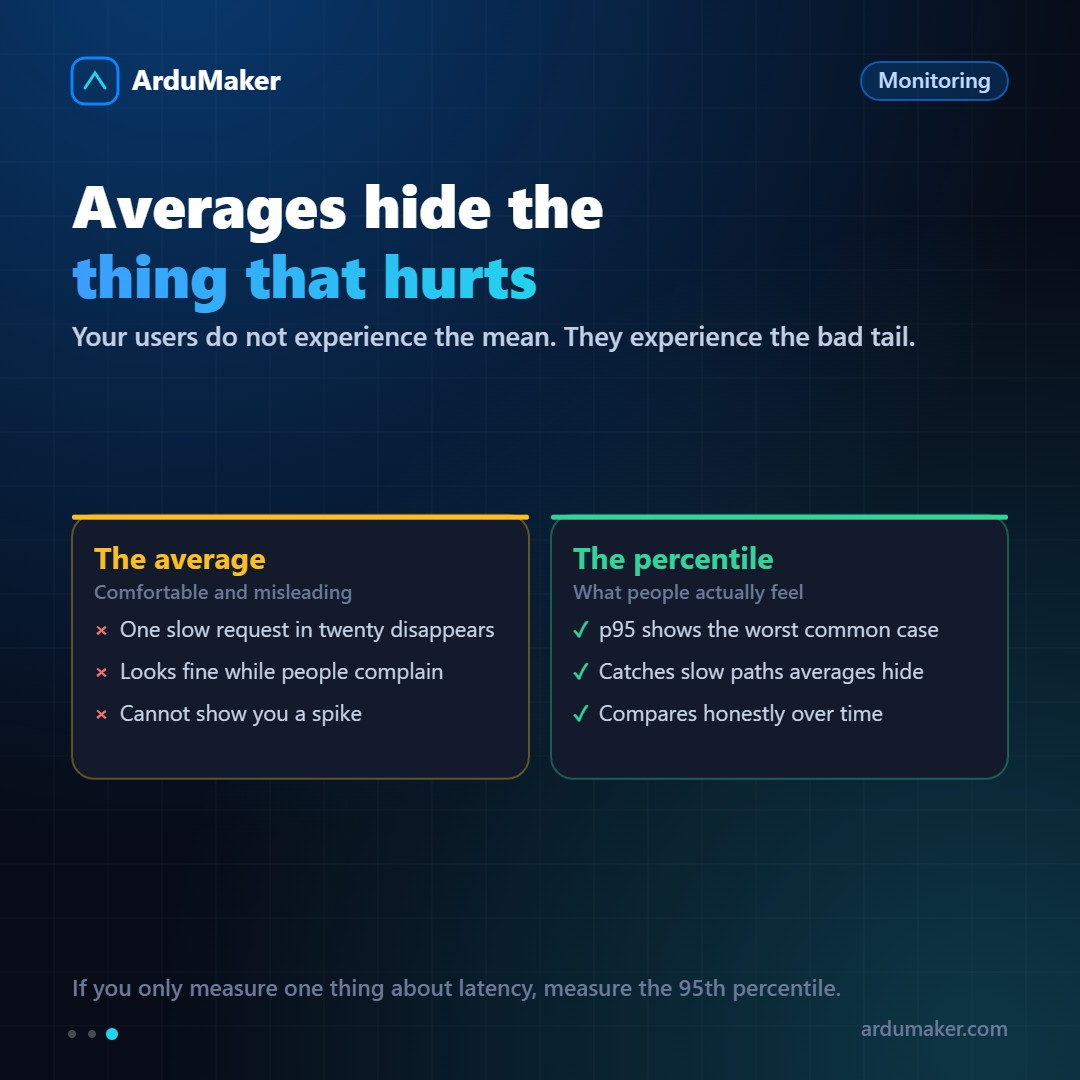
As médias escondem exatamente o que dói.
Se uma de cada vinte requisições demora cinco segundos e o resto cem milissegundos, a média parece boa e há usuários irritados.
Por isso convém medir percentis. O percentil 95 diz: 95% das requisições foram mais rápidas que este valor. É o pior caso comum, e é o que as pessoas sentem.
Se você vai medir apenas uma coisa sobre a latência da sua aplicação, meça o percentil 95.
E o que dá sentido a tudo
Um número sem história não serve. Saber que a carga é 3 não diz nada; saber que há uma semana era 0,8 diz tudo.
Por isso o monitoramento com histórico vale mais que qualquer painel instantâneo. No ArduMaker o sistema de estado revisa hosts, VPS e domínios em ciclo contínuo e guarda 45 dias de histórico, que é o que permite responder "isso vem acontecendo há quanto tempo?" em vez de olhar um número solto.