Os passos para encontrar uma falha em um servidor
Publicado em 2026-09-12 por frfrand
Un método en seis pasos que evita el diagnóstico a ciegas: qué preguntar primero, en qué orden mirar, cómo descartar de a una y por qué el reinicio va al final.
Algo não está funcionando. A tentação é abrir cinco terminais e começar a olhar coisas. Quase sempre isso demora mais do que seguir uma ordem.
Este é um método que funciona.
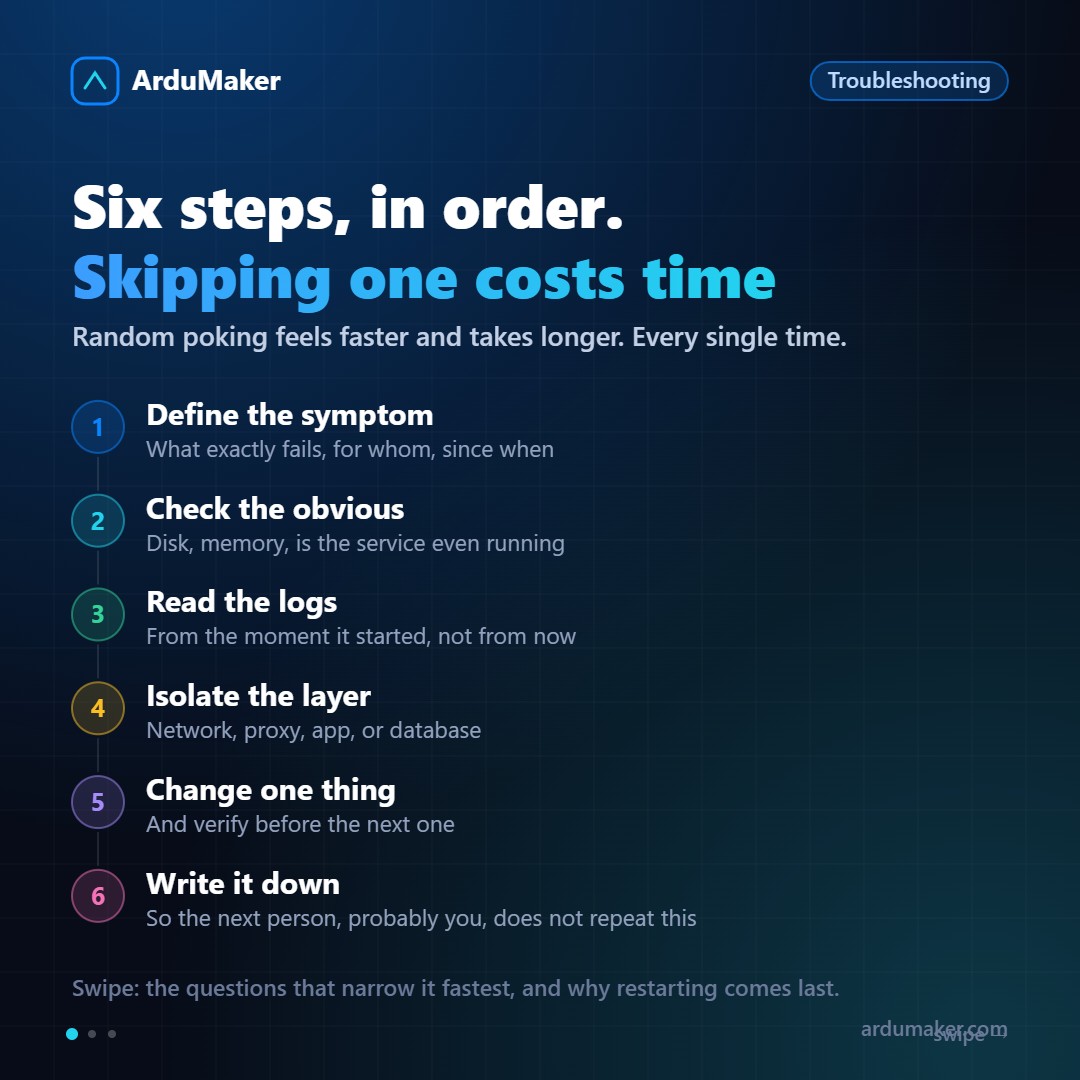
1. Definir o sintoma com precisão
Antes de tocar em nada, responda:
- O que falha exatamente. "O site não está funcionando" não serve. Dá erro, demora, mostra algo incorreto? Qual o código de status?
- Para quem. Todos os usuários ou alguns? De todas as redes?
- Desde quando. E acima de tudo: o que mudou por volta desse momento. Um deploy, uma atualização, um pico de tráfego, um certificado que expirou.
Essa última pergunta resolve mais incidentes do que qualquer ferramenta. A enorme maioria das falhas em produção segue a uma mudança.
2. O óbvio, que nem sempre se olha
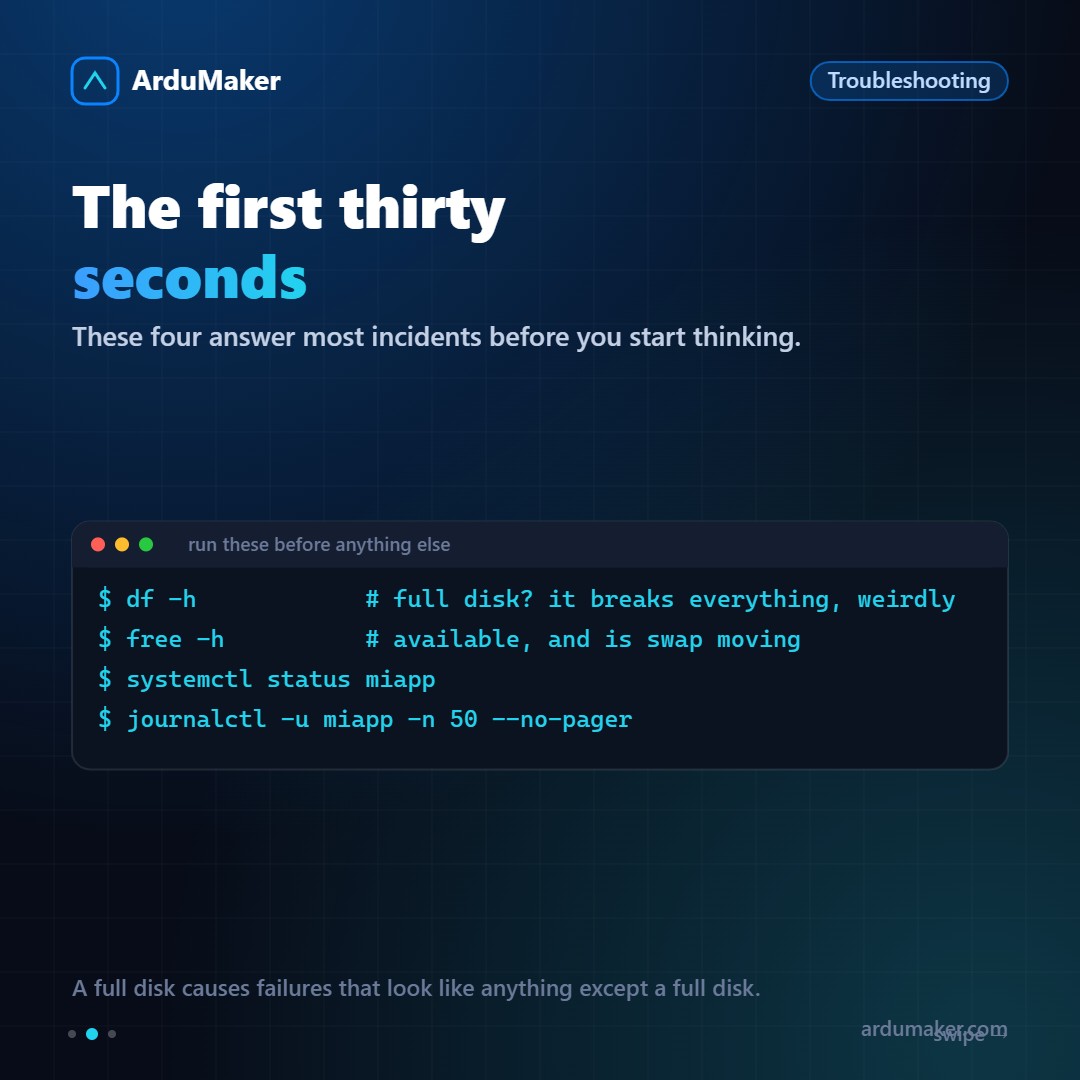
Quatro comandos, trinta segundos:
df -h # disco cheio free -h # memória disponível systemctl status miapp journalctl -u miapp -n 50 --no-pager
O disco cheio merece ênfase à parte. Quando não sobra espaço, as falhas que produz não se parecem em nada com "disco cheio": o banco não consegue gravar seu registro, o aplicativo não consegue criar arquivos temporários, os logs deixam de ser gravados justamente quando mais precisamos. Parece caótico e a causa é uma só.
E fique de olho nos inodos: eles podem se esgotar com o disco pela metade se houver muitos arquivos pequenos.
df -i
3. Ler os logs desde o início
O erro importante quase nunca é o último. É o primeiro.
Quando um sistema se quebra, produz uma cascata: a falha original gera dez erros derivados. Se você olhar as últimas linhas, está vendo as consequências.
journalctl -u miapp --since "14:30" --no-pager
Vá ao momento em que começou, não ao momento atual.
4. Isolar a camada
Uma requisição atravessa várias camadas. É preciso descobrir onde ela é interrompida, e isso se faz de fora para dentro:
- O servidor responde? Um ping ou uma conexão à porta.
- O nginx responde? Solicitar algo estático.
- A aplicação responde diretamente, pulando o proxy? Uma requisição ao localhost na porta dela.
- O banco de dados responde? Conectar e fazer uma consulta trivial.
A primeira que falhar é onde está o problema. Essa ordem evita horas olhando a camada errada.
5. Uma mudança por vez
Quando você encontra a causa provável, mude uma única coisa e verifique.
Se você mudar três e funcionar, não saberá qual era, não aprendeu nada, e provavelmente deixou duas mudanças desnecessárias que vão confundir alguém daqui a seis meses.
6. Anotar
Três linhas: o que estava acontecendo, o que era, o que foi feito. Em um arquivo do servidor, no ticket, onde for.
O valor aparece da próxima vez, quando alguém buscar o mesmo sintoma.
Sobre reiniciar
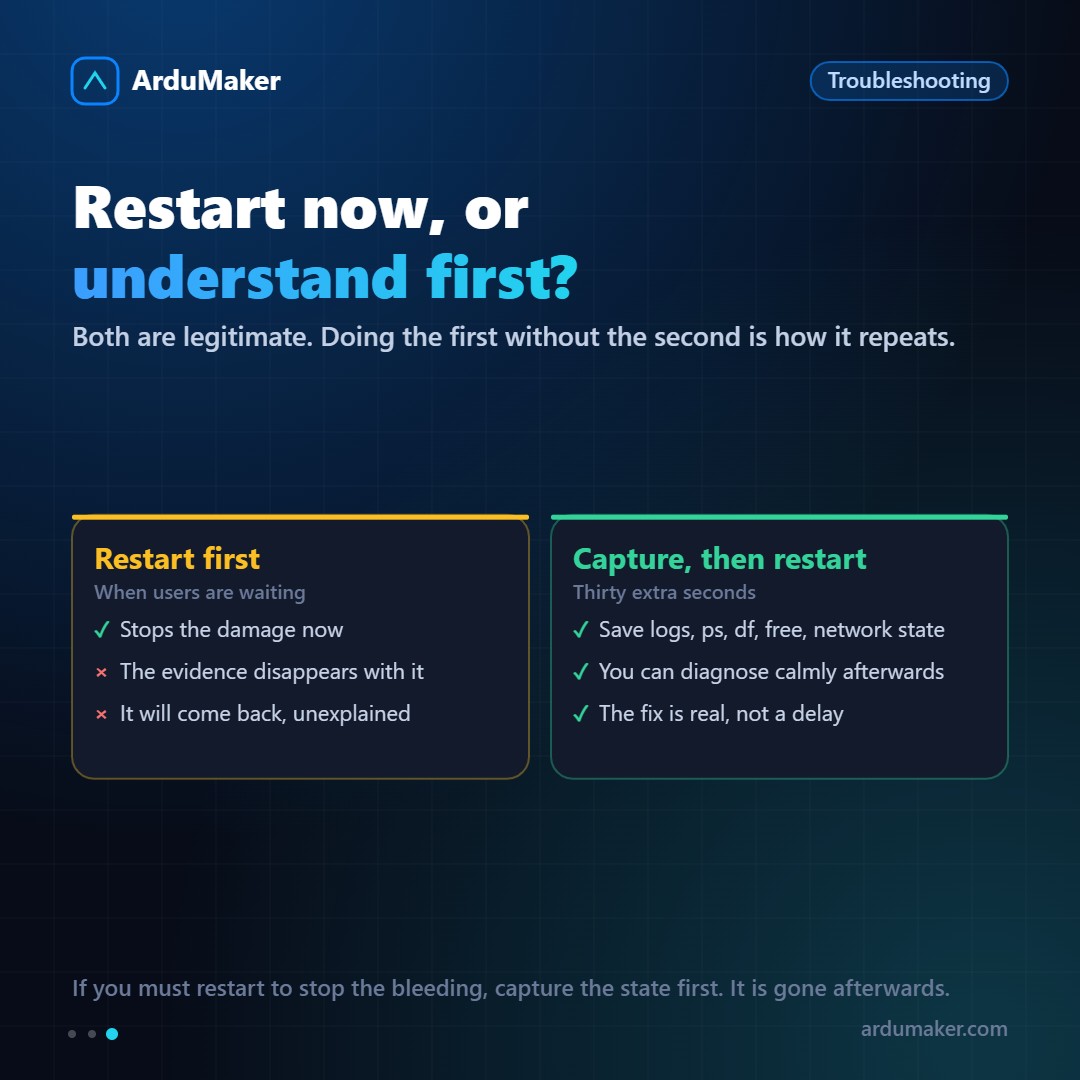
Reiniciar é legítimo quando há usuários esperando: interrompe o dano.
O problema é reiniciar sem capturar nada, porque com a reinicialização a evidência se vai e o problema volta sem explicação.
Antes de reiniciar, trinta segundos:
journalctl -u miapp -n 500 > /tmp/incidente.log ps aux > /tmp/incidente-ps.txt df -h; free -h; ss -tulpn
Com isso você pode reiniciar tranquilo e diagnosticar depois, com calma.