Dicas para usar um servidor sem quebrá-lo
Publicado em 2026-09-12 por frfrand
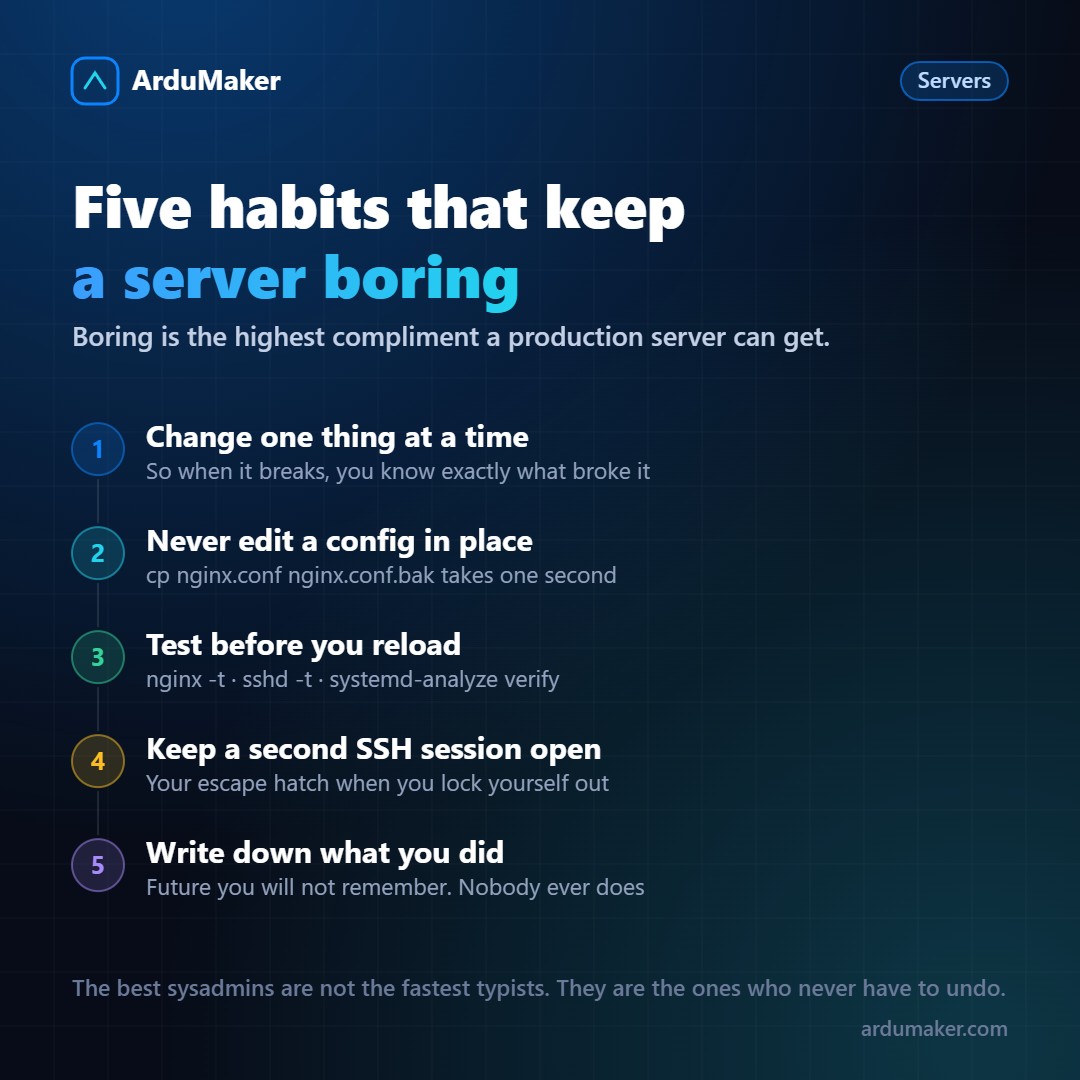
Cinco costumbres que evitan la mayoría de los incidentes en un servidor: un cambio por vez, copias antes de editar, validar antes de recargar, dejar una sesión de rescate y documentar.
A maioria das quedas que vi em produção não foram ataques nem falhas de hardware. Foram mudanças feitas com pressa, sem rede de contenção.
A boa notícia é que quase todas são evitadas com hábitos, não com ferramentas caras. Estas são as cinco que mais vezes me salvaram.
1. Uma mudança por vez
Parece óbvio até que você está com o site fora do ar às onze da noite e tocou no nginx, no firewall e em uma variável de ambiente na mesma rodada.
Quando algo quebra depois de três mudanças simultâneas, você não tem um problema: tem três suspeitos e nenhuma forma de saber qual foi. Pior ainda, às vezes a causa é a interação entre dois deles.
A regra prática: uma mudança, verificar, e somente então a próxima. Parece mais lento e acaba sendo muito mais rápido.
2. Nunca editar um arquivo de configuração sem copiá-lo antes
cp /etc/nginx/sites-available/mi-sitio /etc/nginx/sites-available/mi-sitio.bak
Um segundo. É isso que custa ter para onde voltar.
E uma variante que vale ouro quando a mudança é grande: copie o arquivo com a data no nome (mi-sitio.2026-11-01.bak). Quando dentro de dois meses aparecer um comportamento estranho, você poderá comparar com a versão que funcionava.
Se o servidor permitir, melhor ainda: leve os arquivos de configuração para um repositório git. Um "git diff" responde em dois segundos à pergunta "o que mudou aqui?".
3. Validar antes de recarregar
Quase todos os serviços sérios trazem um modo de validação. É pouco usado e é o que separa um susto de uma queda:
nginx -t # revisa a sintaxe do nginx sshd -t # revisa a config do SSH systemd-analyze verify mi.service apachectl configtest
nginx -t te diz o arquivo e o número da linha do erro. Se, em vez disso, você fizer systemctl reload nginx com um erro de sintaxe, o nginx se recusa a iniciar com a nova configuração e, dependendo do caso, você fica sem site.
A ordem correta é sempre: editar → validar → recarregar → verificar se responde.
4. Deixar uma segunda sessão aberta
Esta é a que mais vezes salva de um desastre real.
Quando for mexer no firewall, na configuração do SSH ou nas permissões do seu usuário, abra uma segunda sessão SSH antes e não a feche. Faça a mudança em uma e teste entrar do zero na outra.
Se você errou e ficou de fora, a sessão antiga continua viva e você pode reverter. Se fechou tudo e ficou travado, a única saída é o console do provedor, e às vezes nem isso.
Regra mental: antes de tocar em qualquer coisa que controle seu próprio acesso, pergunte a si mesmo "se isso der errado, como volto a entrar?".
5. Anotar o que você fez
Não é necessário um documento formal. Um arquivo NOTAS.md no servidor, ou um canal do Slack, ou um comentário no ticket. Três linhas:
2026-11-01 · subí worker_connections a 2048 em nginx.conf porque apareciam 'worker_connections are not enough' backup em nginx.conf.2026-11-01.bak
O valor real aparece meses depois, quando alguém (provavelmente você) perguntar por que esse número está em 2048 e não no valor padrão. Sem a nota, a resposta é "não faço ideia, não mexa". Com a nota, é possível decidir.
O que elas têm em comum
Nenhuma das cinco é técnica. Todas são maneiras de deixar uma saída para você.
Um servidor bem administrado não é o que tem a configuração mais engenhosa: é o chato, o que faz a mesma coisa todos os dias e do qual ninguém se lembra. Chato é o maior elogio que você pode fazer à produção.
Na ArduMaker parte disso vem de fábrica: cada comando executado em um VPS fica registrado com quem o lançou e quando, então o "o que mudou aqui?" tem resposta mesmo que ninguém tenha feito anotações. Mas as outras quatro continuam sendo suas.