Como os processos filhos são gerenciados no Linux
Publicado em 2026-09-12 por frfrand
Qué hacen fork y exec, por qué existen los procesos zombis y qué significan realmente, quién adopta a los huérfanos, y por qué tu contenedor ignora la señal de apagado.
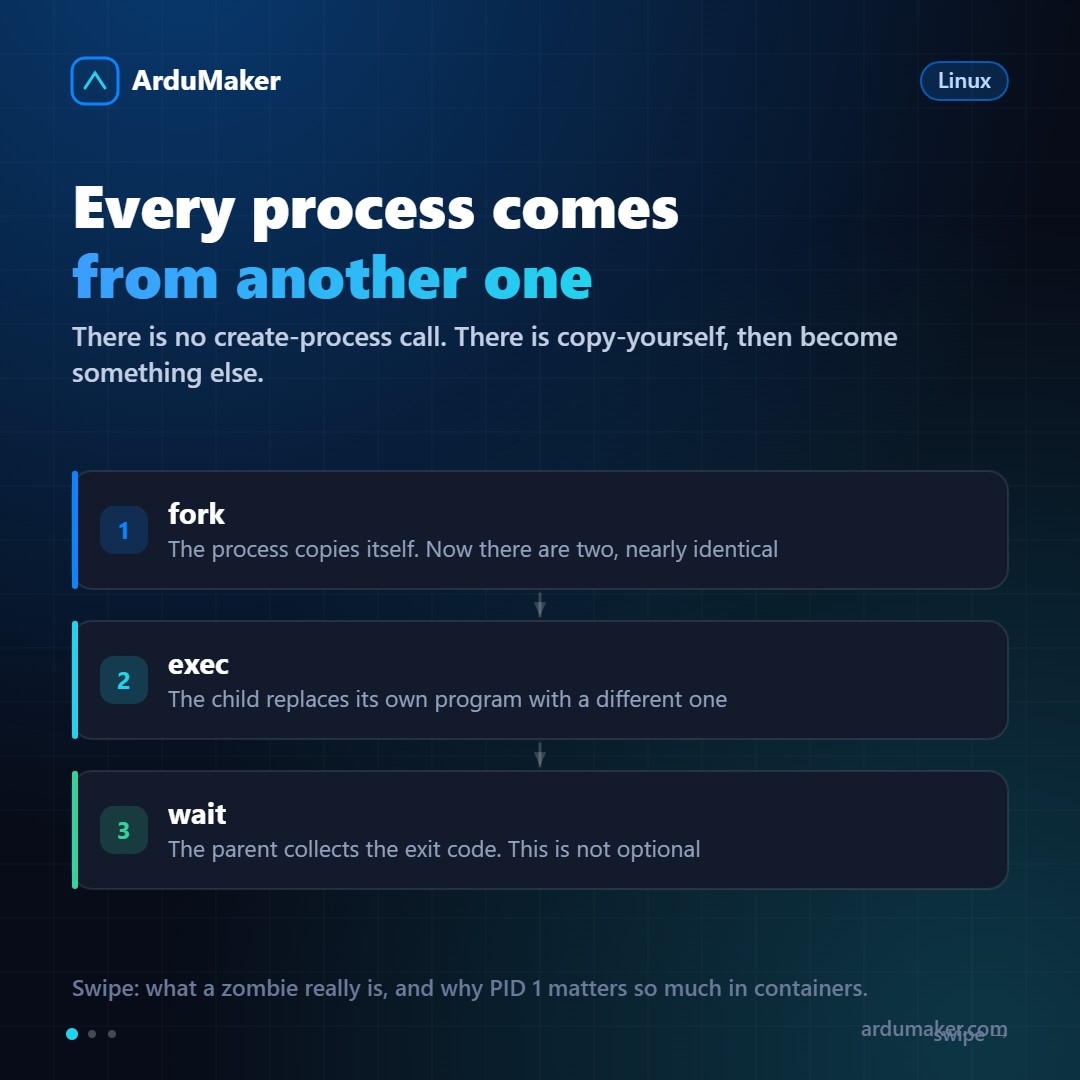
No Linux não existe uma chamada para "criar um processo do zero". Existe uma para copiar a si mesmo, e outra para substituir o programa que você está executando. Tudo o mais sai da combinação dessas duas.
fork e exec
fork duplica o processo atual. Depois da chamada, existem dois processos quase idênticos, com a mesma memória (compartilhada de forma inteligente até que alguém escreva) e os mesmos arquivos abertos. A única diferença é o valor que a chamada retorna: para o pai, retorna o identificador do filho, e para o filho, retorna zero. Assim, cada um sabe quem é.
exec substitui o programa do processo atual por outro. Não cria nada: o identificador continua o mesmo, o que muda é o código que é executado.
Quando o shell executa um comando, faz exatamente isso: se copia com fork, e na cópia chama exec com o programa que você pediu.
Parece rebuscado e é muito poderoso: entre o fork e o exec, o filho pode mudar coisas (redirecionar sua entrada e saída, mudar de usuário, ajustar limites). É aí que são implementados os pipes e as redirecionamentos do shell.
Os zumbis, que estão mal explicados em todos os lugares
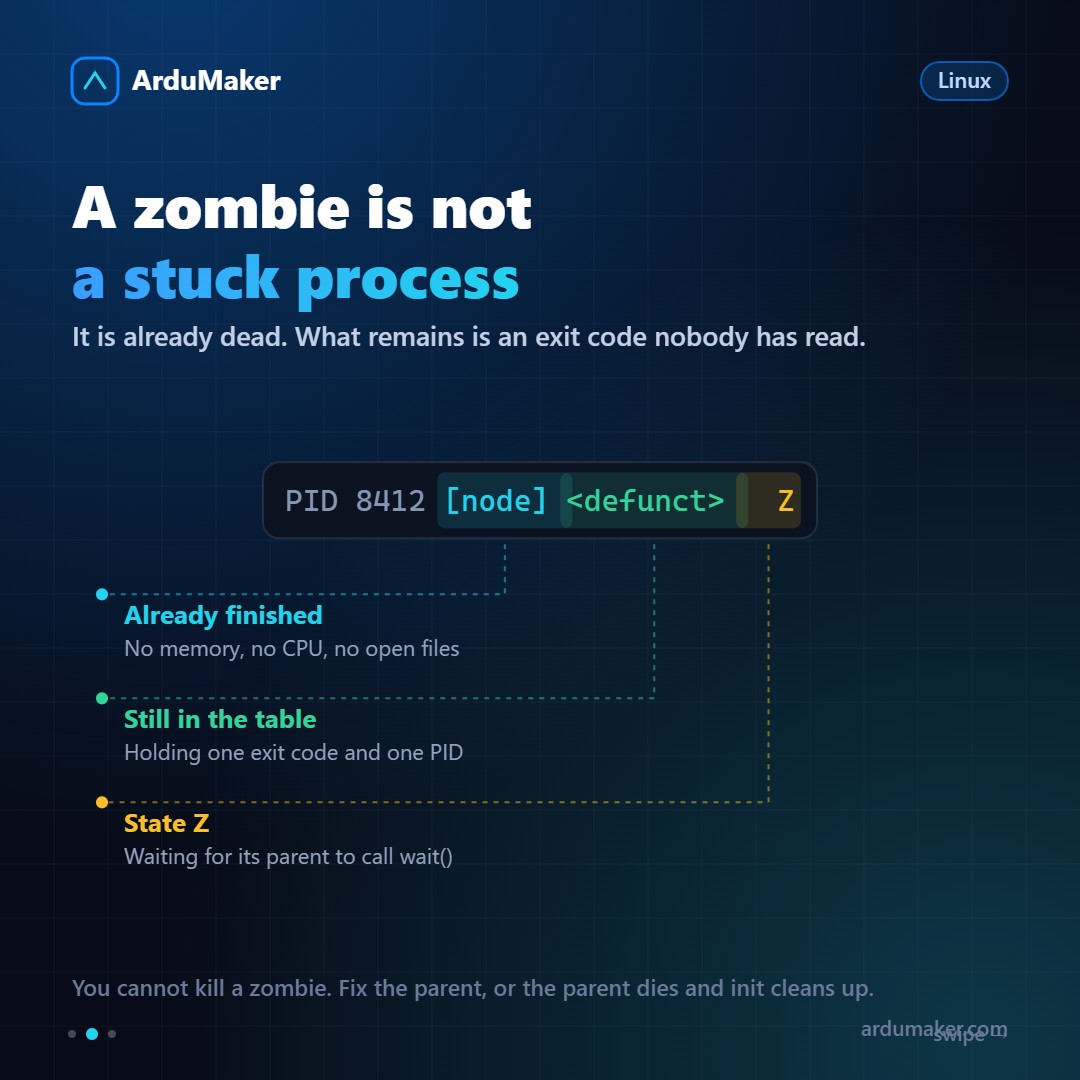
Quando um processo termina, não desaparece completamente. O kernel guarda uma entrada mínima com seu código de saída, esperando que o pai a leia com wait.
Esse estado intermediário é um zumbi.
Duas esclarecimentos importantes:
Um zumbi não consome nada. Não tem memória, nem CPU, nem arquivos abertos. É uma entrada em uma tabela. A única coisa que retém é seu número de identificador.
Não se pode matar um zumbi. Ele já está morto. Enviar um sinal não faz nada. A forma de eliminá-lo é que o pai leia seu status, ou que o pai termine.
Então, por que são um problema? Porque se um programa cria muitos filhos e nunca chama wait, os zumbis se acumulam e podem esgotar a tabela de processos. O sintoma é "não é possível criar mais processos" com a máquina aparentemente ociosa.
E a solução nunca é matar os zumbis: é corrigir o pai.
Os órfãos, que são o contrário
Se o pai terminar antes do filho, o filho fica órfão. O kernel o atribui imediatamente a init (o processo 1), que está programado para ler o status de qualquer filho que termine.
Por isso um órfão nunca fica zumbi: init o recolhe. É também o mecanismo pelo qual um processo se "desprende" para rodar em segundo plano de forma permanente.
Por que o PID 1 é especial, e seu contêiner sofre com isso
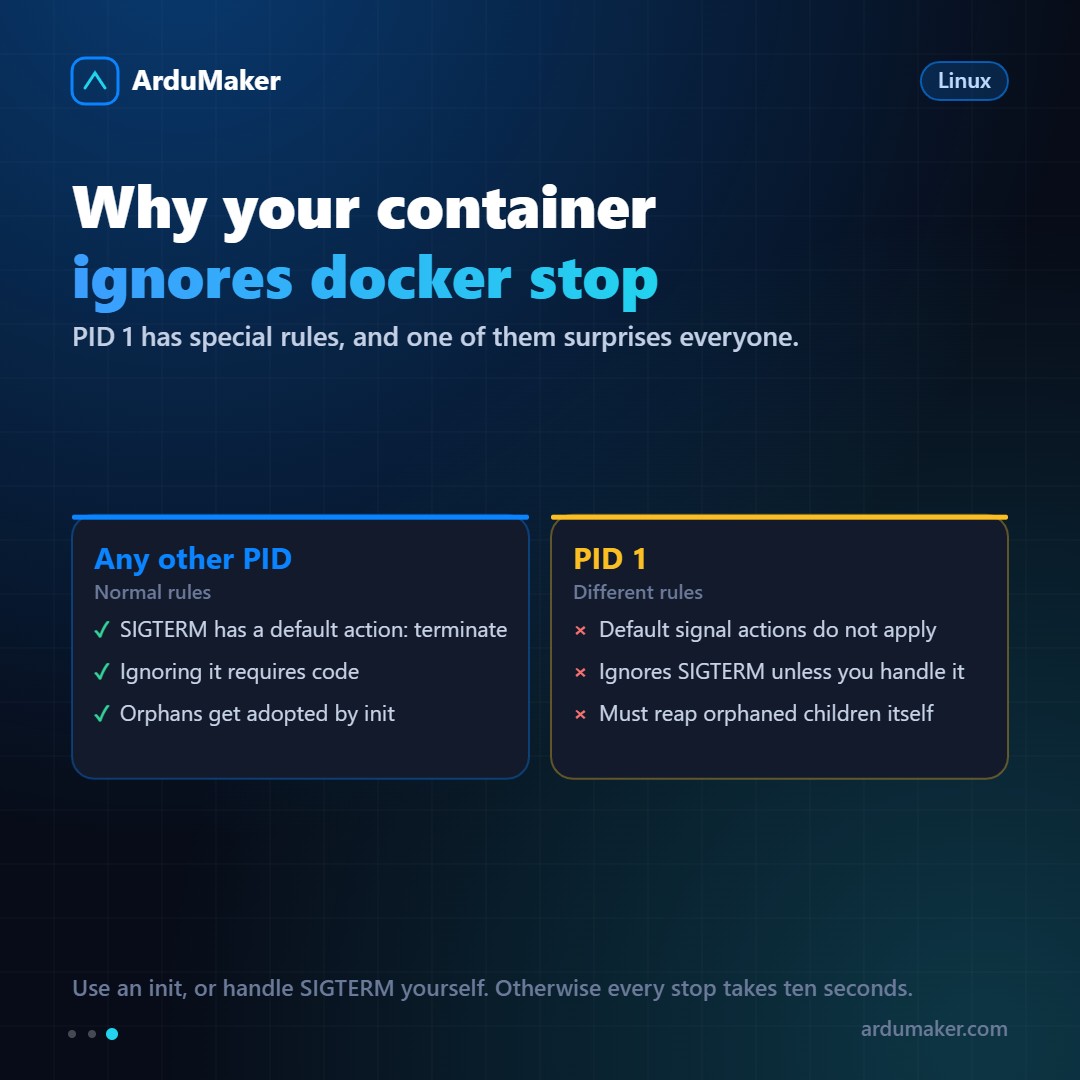
O processo 1 tem regras diferentes, e há uma que surpreende todo mundo:
Para o processo 1, os sinais não têm ação por padrão.
Para qualquer outro processo, receber o sinal de término o termina, mesmo que seu código não faça nada a respeito. Para o processo 1, se o programa não instalou explicitamente um manipulador, o sinal é ignorado.
E em um contêiner, seu aplicativo costuma ser o processo 1.
Consequência prática: você manda a ordem de parar o contêiner, seu aplicativo não trata o sinal, não acontece nada. O sistema espera dez segundos e o mata à força. Por isso cada parada demora exatamente dez segundos e as conexões são cortadas de repente.
Duas soluções:
- Tratar o sinal no seu código e encerrar de forma ordenada: parar de aceitar novas conexões, finalizar as que estão em andamento, fechar o banco de dados, sair.
- Usar um init mínimo como processo 1 (a opção --init do Docker, ou tini). Esse init trata os sinais, os encaminha ao seu processo e também coleta os órfãos.
É provavelmente o detalhe de processos que mais impacto tem no dia a dia e menos se explica.