Como funciona o Git por dentro (e por que isso te salva de sustos)
Publicado em 2026-09-12 por frfrand
Git no guarda diferencias: guarda fotos completas. Entender eso explica por qué las ramas son baratas, por qué casi nada se pierde de verdad y qué hace realmente cada comando.
Se pode usar Git durante anos com cinco comandos memorizados e sem entender o que faz. Funciona, até o dia em que algo dá errado e você não sabe por quê.
Entender o modelo leva dez minutos e muda a relação com a ferramenta.
Os três lugares
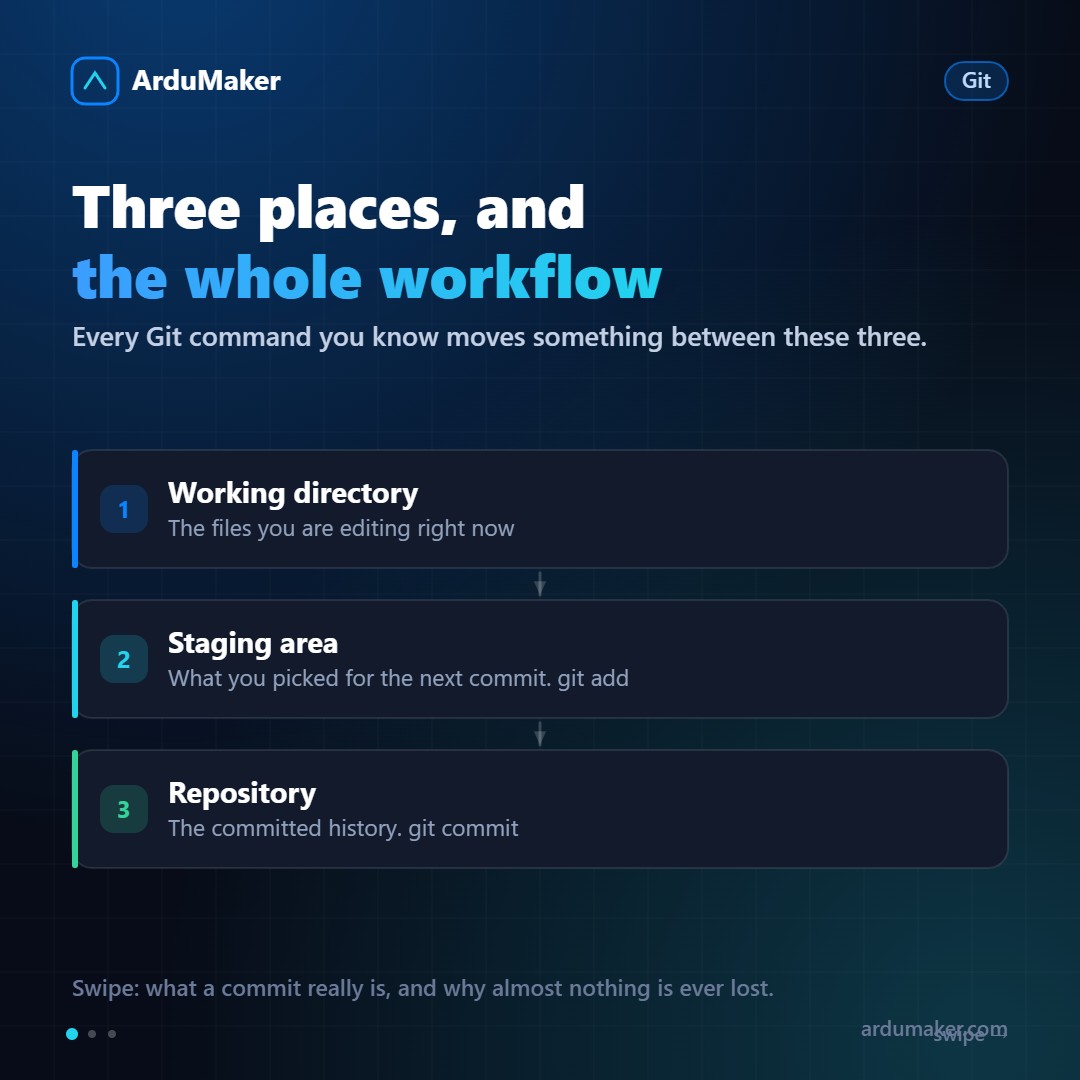
Todo comando do Git move algo entre três espaços:
O diretório de trabalho. Os arquivos como estão agora no seu disco.
A área de preparação (staging). Uma zona intermediária onde você monta o próximo commit. Quando faz git add, move mudanças para cá.
O repositório. O histórico confirmado. git commit pega o que está em staging e salva.
Essa zona intermediária confunde no início e é justamente o que torna o Git poderoso: permite escolher qual parte do seu trabalho entra em cada commit. Você pode ter cinco arquivos modificados e confirmar apenas dois, ou mesmo apenas algumas linhas de um com git add -p.
Um commit não é uma diferença
Aqui está o mal-entendido mais comum. A maioria acredita que um commit salva "o que mudou". Não é assim.
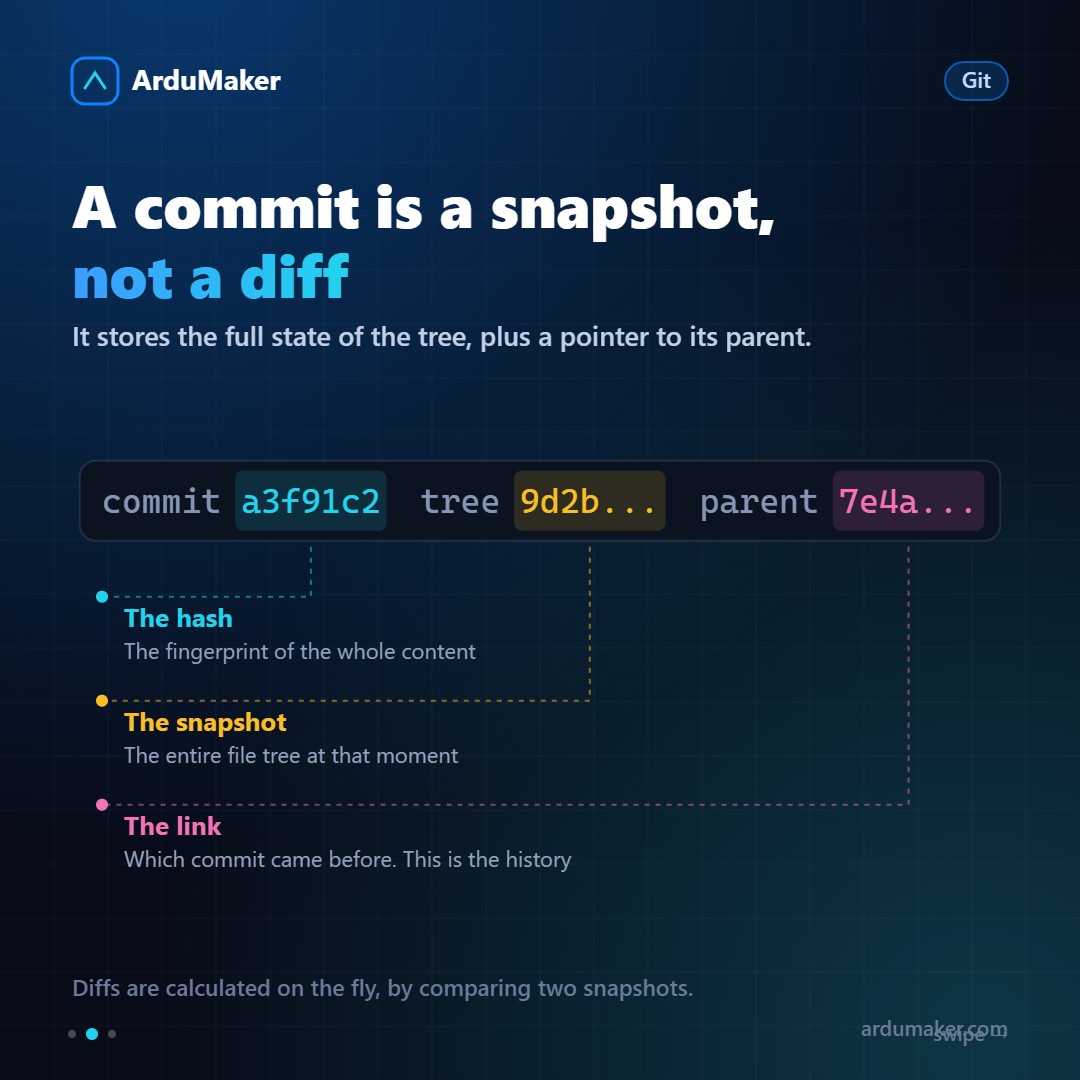
Um commit salva uma foto completa da árvore de arquivos naquele momento, mais um ponteiro para o commit anterior e alguns metadados.
As diferenças que você vê no git diff ou no GitHub são calculadas na hora, comparando duas fotos.
Não ocupa muito? Não, por duas razões: os arquivos que não mudaram são reutilizados (o Git guarda conteúdos pelo hash deles, então o mesmo conteúdo é armazenado apenas uma vez), e depois comprime tudo.
Desse design saem duas consequências importantes:
- Os ramos são baratíssimos. Um ramo é um arquivo de 41 bytes que aponta para um commit. Criar um é instantâneo. Por isso o fluxo de trabalho do Git incentiva criar ramos para tudo, algo impensável em sistemas anteriores.
- O histórico é verificável. O hash de um commit é calculado a partir do seu conteúdo, que inclui o hash do pai. Alterar algo antigo muda todos os hashes seguintes. Por isso reescrever o histórico compartilhado causa tantos problemas.
HEAD, ramos e o "detached HEAD"
HEAD é um ponteiro que diz onde você está parado.
Normalmente HEAD aponta para um ramo, e o ramo aponta para um commit. Quando você faz um novo commit, o ramo avança e HEAD vai com ele.
Se você fizer checkout de um commit diretamente, HEAD aponta para o commit sem passar por um ramo. Isso é o famoso "detached HEAD". Não está quebrado: simplesmente, se você fizer commits lá e sair, esses commits não terão nenhum ramo que os sustente. Por isso o aviso.
O comando que salva o dia
Este único dado justifica todo o artigo.
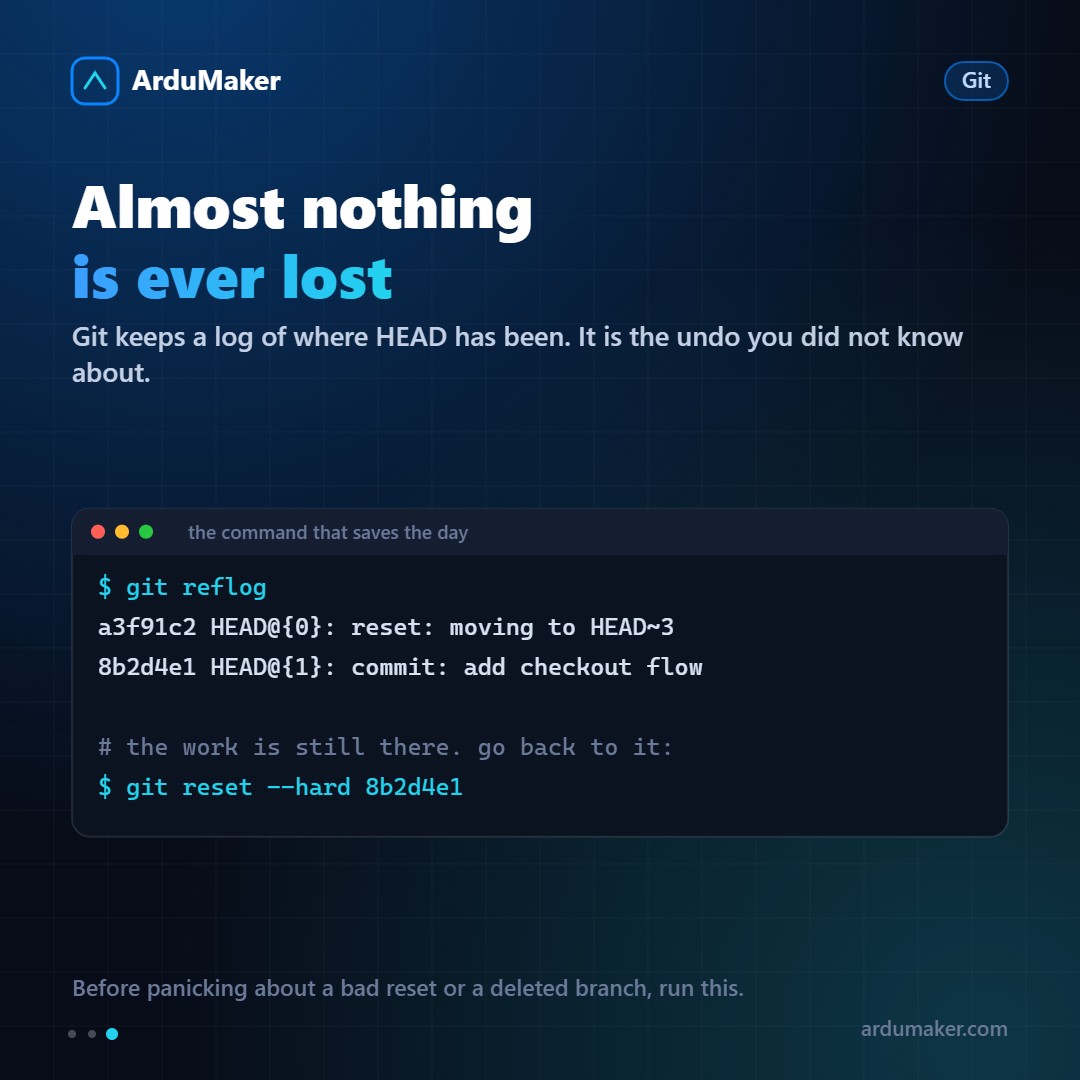
O Git mantém um registro de todas as posições pelas quais HEAD passou: o reflog.
git reflog
Se você fez um reset que não deveria, se excluiu um ramo por engano, se se perdeu no meio de um rebase, aí está a lista de onde você esteve, com o seu hash. Voltar é:
git reset --hard <hash>
Os commits órfãos permanecem no repositório durante semanas antes que o coletor de lixo os limpe. Quase nada se perde de verdade no Git. O que se perde são as alterações que nunca foram confirmadas, e para isso está o costume de fazer commits pequenos e frequentes.
O que convém ter em mente
- Um commit é uma foto com um ponteiro para o pai.
- Uma branch é um ponteiro para um commit, e é grátis.
- HEAD diz onde você está.
- O reflog lembra onde você esteve.
Com isso, os comandos deixam de ser fórmulas mágicas e passam a ser operações que você pode raciocinar.