Qué son los microservicios y por qué aparecieron
Publicado el 2026-09-12 por frfrand
No nacieron por una razón técnica sino organizativa. Qué problema resuelven de verdad, qué costos traen y por qué el monolito modular es la respuesta correcta para la mayoría.
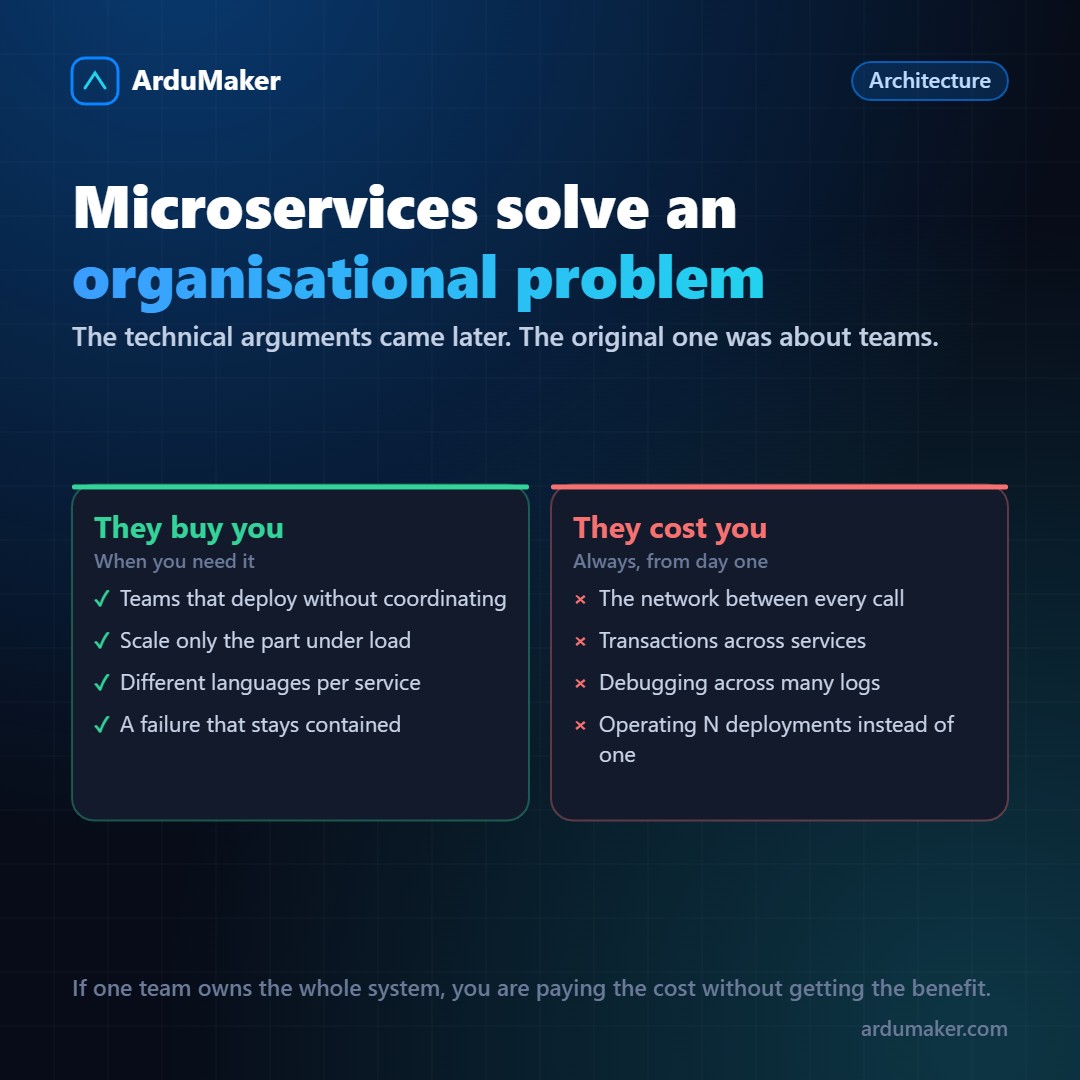
Un microservicio es un servicio pequeño, desplegable de forma independiente, responsable de una capacidad de negocio, que se comunica con los demás por la red.
Esa es la definición. Lo interesante es de dónde vino la idea, porque explica cuándo tiene sentido.
No nació por una razón técnica
Las empresas que popularizaron este enfoque no tenían un problema de rendimiento. Tenían un problema de organización.
Cuando doscientas personas trabajan sobre el mismo código y el mismo despliegue, aparece un cuello de botella que no es técnico: cada cambio hay que coordinarlo, cada publicación afecta a todos, y la velocidad de todo el mundo queda limitada por el equipo más lento.
Los microservicios atacan eso: si cada equipo tiene su servicio, su base y su despliegue, cada uno avanza a su ritmo.
De ahí sale la regla más útil para decidir: si toda tu aplicación la lleva un solo equipo, estás pagando los costos sin recibir el beneficio principal.
Lo que sí aportan en lo técnico
Escalar por partes. Si el procesamiento de imágenes consume mucho y el resto no, escalás sólo esa parte. En un monolito escalás todo junto.
Aislar fallas. Un servicio que se cae no tiene por qué llevarse al resto, si el sistema está diseñado para tolerarlo. Sin esa parte, en realidad multiplicaste los puntos de falla.
Tecnologías distintas. Un servicio de cálculo intensivo en un lenguaje compilado, el resto en otro. Útil a veces, y una fuente enorme de complejidad si se abusa.
Lo que cuestan, desde el día uno
Acá conviene ser muy honesto, porque estos costos aparecen incluso en sistemas chicos.
La red entre cada llamada. Lo que era una llamada a función pasa a ser una petición HTTP: latencia, serialización, y la posibilidad de que falle. Todo el código de reintentos, tiempos de espera y circuit breakers que antes no existía, ahora es tuyo.
Las transacciones. En una base, envolver varias operaciones en una transacción es trivial. Repartido entre tres servicios con tres bases, eso desaparece. Hay que implementar consistencia eventual y compensaciones, que es mucho más difícil de lo que suena.
La depuración. Un error que atraviesa cinco servicios está en cinco logs distintos. Sin trazado distribuido (que hay que montar y mantener) reconstruir qué pasó es muy costoso.
La operación. Diez servicios son diez despliegues, diez configuraciones, diez conjuntos de métricas y alertas.
El monolito modular
Entre los dos extremos hay una opción que suele ser la correcta y se menciona poco: un monolito bien modularizado.
Un solo despliegue, una sola base, y adentro módulos con fronteras claras: cada uno con su interfaz, sin acceder a las tablas de los demás por atrás.
Te da casi todos los beneficios de organización del código sin ninguno de los costos de la red. Y si algún día un módulo necesita separarse de verdad, la frontera ya está trazada, así que extraerlo es factible.
El camino que funciona es ese: empezar con un monolito modular, y extraer un servicio cuando aparezca una razón concreta y medible. No al revés.
La pregunta que ordena la decisión
No es "¿cuál arquitectura es mejor?", sino "¿cuál es mi cuello de botella real?".
Si es que varios equipos se pisan al desplegar, los microservicios lo resuelven.
Si es que una consulta no tiene índice, o que falta caché, o que el servidor está justo de memoria, los microservicios no resuelven nada y suman trabajo permanente.