Por qué existen el frontend y el backend como cosas separadas
Publicado el 2026-09-12 por frfrand
No es una moda ni una forma de dividir tareas: son dos entornos con reglas incompatibles. Qué corre en cada lado, por qué nunca hay que confiar en el navegador y dónde va cada validación.
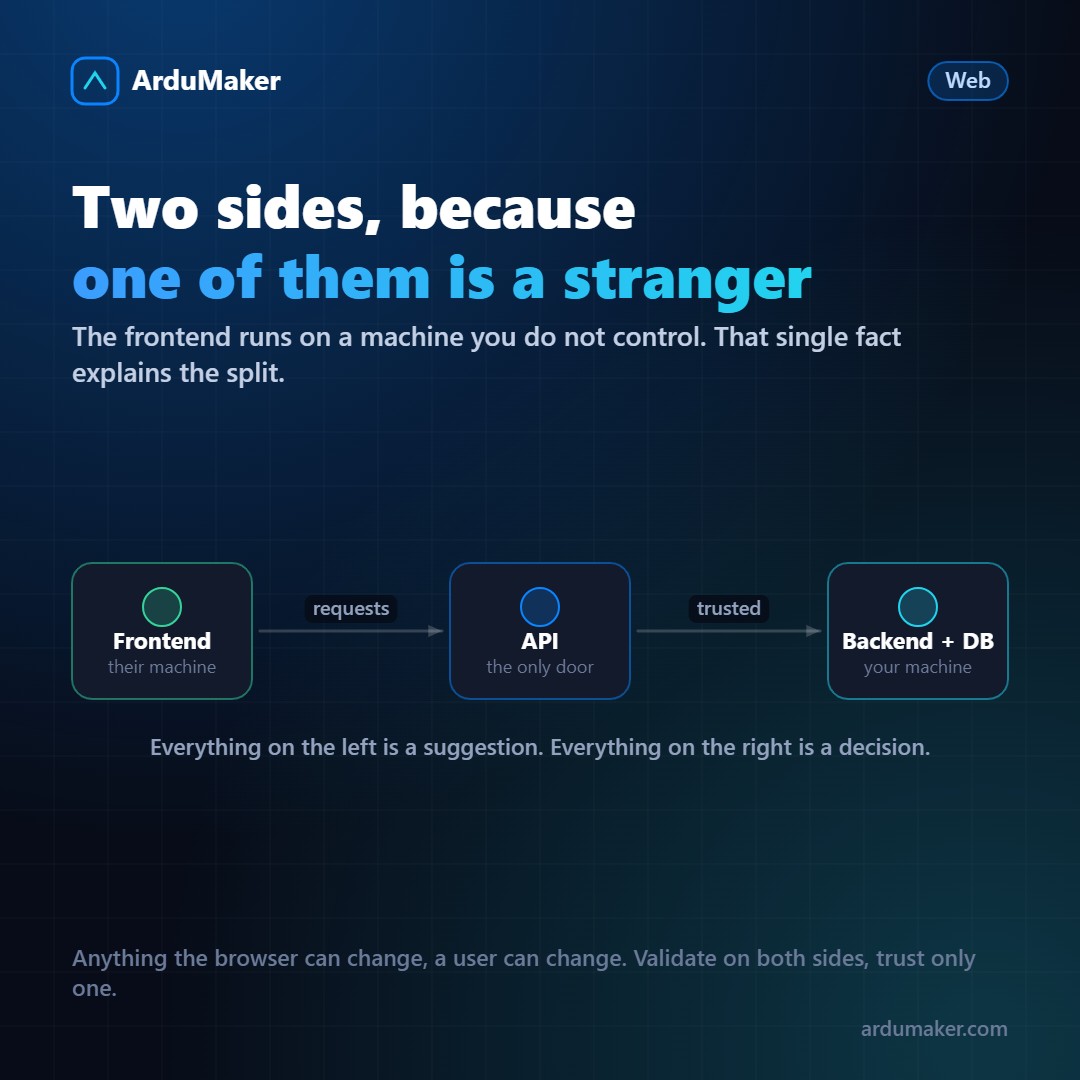
Mucha gente escucha "frontend y backend" y lo entiende como una división del trabajo: unos hacen lo visual y otros la lógica. Es cierto como descripción de roles, pero se queda corto y lleva a decisiones equivocadas.
La separación real es más profunda: son dos entornos con propiedades incompatibles.
La diferencia que lo explica todo
El frontend corre en la máquina de otra persona.
Eso es todo. De ahí sale el resto.
El código que mandás al navegador está en manos del usuario: puede leerlo, modificarlo, ejecutarlo a mano, o directamente ignorarlo y mandar peticiones con otra herramienta. No hay forma de impedirlo, porque para funcionar el navegador necesita entender lo que le mandaste.
El backend corre en tu servidor, donde vos controlás quién entra y qué se ejecuta.
Por eso cualquier cosa que tenga que ser cierta, tiene que decidirse en el backend.
La consecuencia práctica
Un ejemplo que se repite: un formulario que valida que la edad sea mayor a 18. Se valida en el frontend para que el usuario reciba el aviso al instante, sin esperar al servidor. Perfecto.
Y también hay que validarlo en el backend. No por desconfianza hacia ese usuario: porque la petición puede llegar sin pasar por tu formulario.
La regla corta: validar en el frontend es una cortesía, validar en el backend es la regla.
Lo mismo con los precios, los permisos, el stock y los descuentos. Si el navegador manda "precio: 0", el servidor tiene que ignorar ese dato y buscar el precio real.
Qué vive en cada lado
Frontend: estructura visual, estilos, interacciones, validaciones inmediatas, estado de la interfaz, animaciones.
Backend: reglas de negocio, permisos, acceso a la base de datos, integraciones con servicios externos, secretos.
Esa última palabra merece énfasis. Las claves de API, las credenciales de la base y los tokens de servicios pagos no pueden estar en el frontend. Ni siquiera "ofuscados": todo lo que llega al navegador es visible.
El límite entre los dos: la API
La conversación pasa por una interfaz explícita, normalmente HTTP con JSON.
Esa frontera clara es lo que permite que el mismo backend atienda a una web, a una aplicación móvil y a un proceso automático. Y que el equipo de frontend rediseñe todo sin tocar la lógica de negocio.
También es donde conviene ser estricto: la API debería aceptar exactamente lo que necesita y rechazar el resto, con mensajes de error claros. Una API permisiva es cómoda el primer mes y una fuente de bugs para siempre.
Cuándo la separación estorba
Vale decirlo, porque la industria a veces exagera. Para un sitio de contenido, separar en un frontend que consume una API puede ser trabajo extra sin beneficio: el servidor devuelve HTML ya armado y listo.
La separación se paga sola cuando hay varias interfaces contra el mismo backend, cuando los equipos son distintos, o cuando la interfaz es muy interactiva. Para un blog, no.
Dónde vive cada cosa en un servidor
En la práctica, los dos terminan en la misma máquina más seguido de lo que se cree: nginx sirve los archivos estáticos del frontend y, cuando la ruta empieza con /api, le pasa la petición al backend que escucha en un puerto local.
En ArduMaker ese reparto se configura desde el panel: un repositorio puede desplegarse como sitio estático y otro como servicio, cada uno con su dominio o su ruta, en el mismo VPS o en distintos.