Qué es un repositorio remoto y por qué existe
Publicado el 2026-09-12 por frfrand
Un remoto no es "la nube": es otra copia del repositorio a la que le pusiste un nombre. Qué hacen fetch, pull y push en realidad, y por qué conviene separar traer de integrar.
Un repositorio remoto suena a "el repositorio en la nube". Es una descripción cómoda y engañosa.
Un remoto es simplemente otra copia del repositorio, en otro lugar, a la que le pusiste un nombre corto para no escribir la dirección cada vez.
$ git remote -v origin git@github.com:empresa/app.git (fetch) origin git@github.com:empresa/app.git (push)
"origin" no tiene nada de especial. Es el nombre por defecto del primero que configurás. Podría llamarse "github", "central" o "pepe".
Por qué hace falta, si Git es distribuido
Técnicamente no hace falta. Dos personas podrían hacer pull directamente una de la máquina de la otra. Git lo soporta.
En la práctica no funciona: las computadoras se apagan, cambian de red, están detrás de routers. Entonces el equipo acuerda un lugar que siempre está disponible, y ese lugar se vuelve el punto de encuentro.
La diferencia con los sistemas centralizados de antes es sutil pero importante: ese servidor es una convención, no una necesidad técnica. Su copia no es más "verdadera" que la tuya; simplemente está siempre encendida.
Tres comandos, y uno que confunde
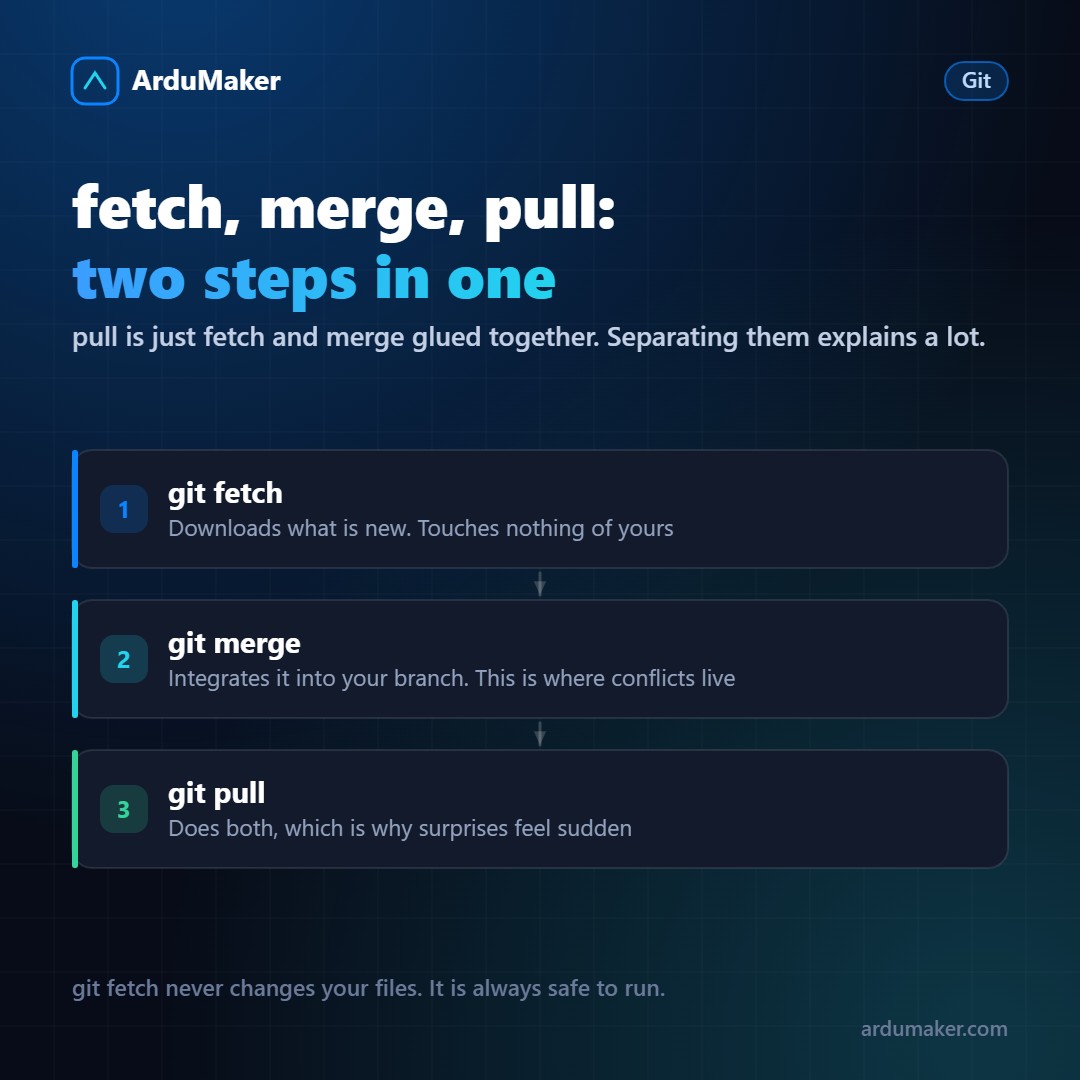
git fetch baja lo que hay de nuevo en el remoto y lo guarda aparte, en referencias como origin/main. No toca tus archivos ni tu rama. Es siempre seguro de correr, y es la respuesta correcta a "¿qué hay de nuevo?".
git merge origin/main integra eso a tu rama actual. Acá es donde pueden aparecer conflictos.
git pull hace los dos, uno después del otro.
Esa fusión de pasos es la causa de una sensación muy común: que los conflictos "aparecen de golpe". No aparecen de golpe; lo que pasa es que pull hizo dos cosas y sólo viste la segunda.
Una costumbre que vale la pena, sobre todo en equipos activos:
git fetch git log --oneline HEAD..origin/main # qué vino git merge origin/main # ahora sí
Tres comandos en vez de uno, y ninguna sorpresa.
push, y por qué a veces lo rechaza
git push manda tus commits al remoto. El remoto lo acepta sólo si tu historia contiene la suya: es decir, si podés avanzar sin perder nada.
Si alguien subió algo que vos no tenés, el push se rechaza. No es un error: es una protección. Si se aceptara, los commits de esa persona quedarían huérfanos.
La solución correcta es traer lo nuevo, integrarlo y volver a empujar.
Y la solución incorrecta, que aparece en muchas respuestas de Internet:
git push --force
Eso reemplaza la historia del remoto por la tuya, y el trabajo de la otra persona desaparece del remoto. Si de verdad hace falta forzar (por ejemplo, después de reescribir tu propia rama), existe una variante mucho más segura:
git push --force-with-lease
Esa falla si el remoto cambió desde la última vez que lo miraste, en vez de pisar a ciegas.
Varios remotos a la vez
Nada te obliga a tener uno solo:
git remote add upstream git@github.com:original/proyecto.git git fetch upstream
Es el flujo clásico cuando trabajás sobre un fork: origin es tu copia, upstream es el proyecto original, y traés de uno y empujás al otro.
También podés tener un remoto que sea tu propio servidor, y desplegar con un push directo.
Una recomendación corta
Configurá el remoto por SSH y no por HTTPS. Con SSH usás tu clave, no escribís contraseñas ni tokens, y funciona igual en tu máquina y en un servidor de integración.
Si ya lo tenés por HTTPS:
git remote set-url origin git@github.com:empresa/app.git