Cómo funciona Git por dentro (y por qué eso te ahorra sustos)
Publicado el 2026-09-12 por frfrand
Git no guarda diferencias: guarda fotos completas. Entender eso explica por qué las ramas son baratas, por qué casi nada se pierde de verdad y qué hace realmente cada comando.
Se puede usar Git durante años con cinco comandos memorizados y sin entender qué hace. Funciona, hasta el día que algo sale mal y no sabés por qué.
Entender el modelo lleva diez minutos y cambia la relación con la herramienta.
Los tres lugares
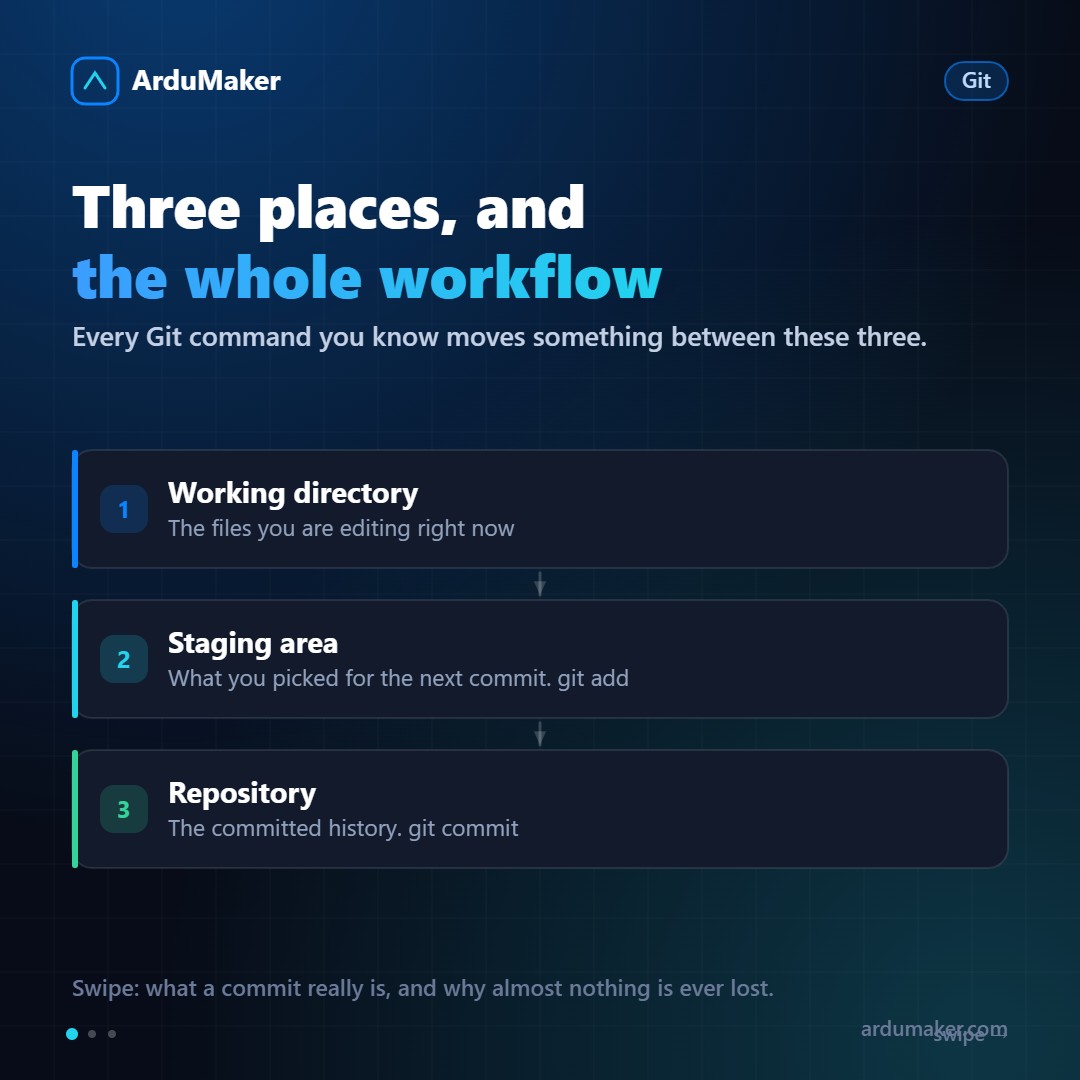
Todo comando de Git mueve algo entre tres espacios:
El directorio de trabajo. Los archivos como están ahora en tu disco.
El área de preparación (staging). Una zona intermedia donde armás el próximo commit. Cuando hacés git add, movés cambios acá.
El repositorio. La historia confirmada. git commit toma lo que hay en staging y lo guarda.
Esa zona intermedia confunde al principio y es justamente lo que hace potente a Git: te permite elegir qué parte de tu trabajo entra en cada commit. Podés tener cinco archivos modificados y confirmar sólo dos, o incluso sólo algunas líneas de uno con git add -p.
Un commit no es una diferencia
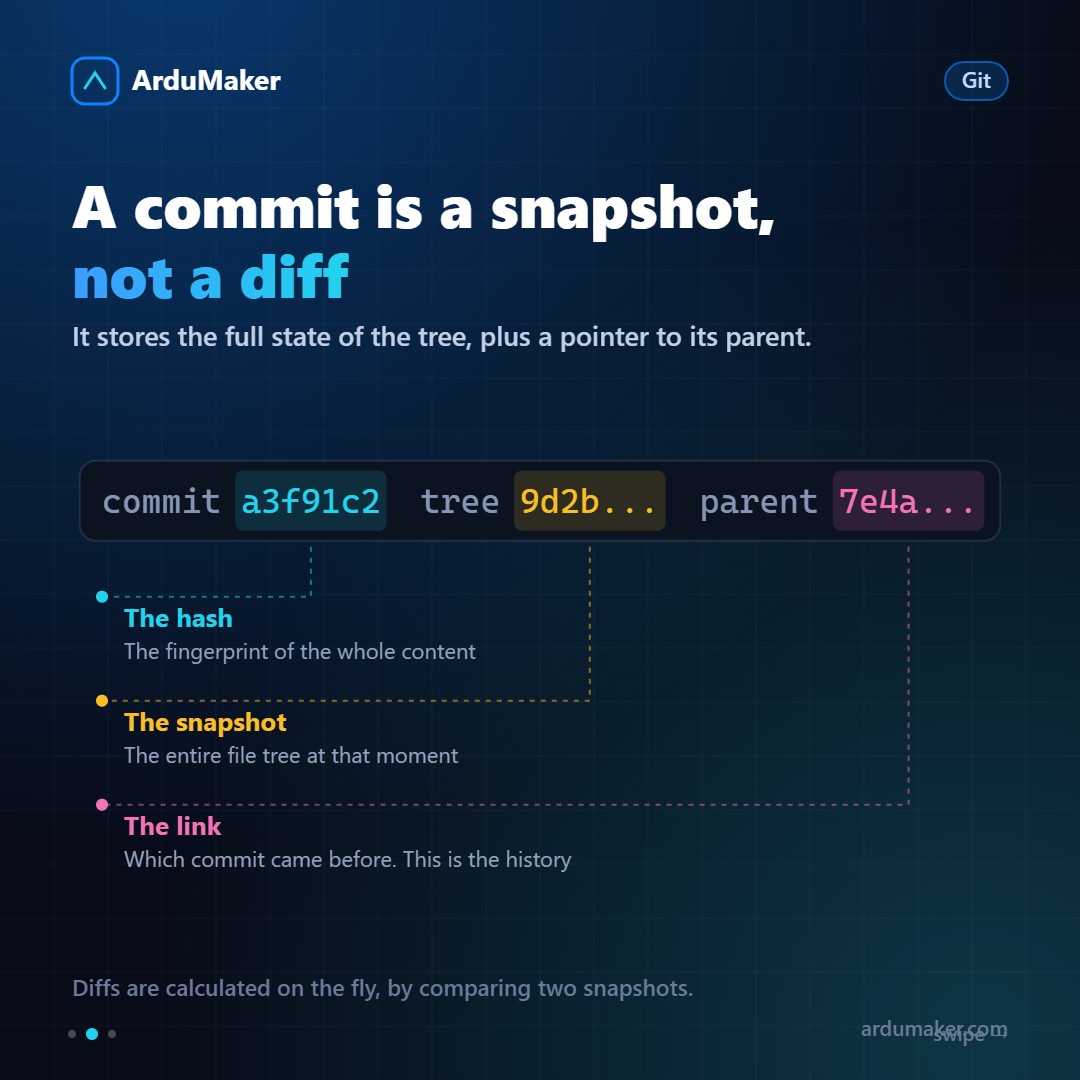
Acá está el malentendido más común. La mayoría cree que un commit guarda "lo que cambió". No es así.
Un commit guarda una foto completa del árbol de archivos en ese momento, más un puntero al commit anterior y algunos metadatos.
Las diferencias que ves en git diff o en GitHub se calculan al vuelo, comparando dos fotos.
¿No ocupa muchísimo? No, por dos razones: los archivos que no cambiaron se reutilizan (Git guarda contenidos por su hash, así que el mismo contenido se almacena una sola vez), y después comprime todo.
De ese diseño salen dos consecuencias importantes:
- Las ramas son baratísimas. Una rama es un archivo de 41 bytes que apunta a un commit. Crear una es instantáneo. Por eso el flujo de trabajo de Git fomenta crear ramas para todo, algo impensable en sistemas anteriores.
- La historia es verificable. El hash de un commit se calcula a partir de su contenido, que incluye el hash del padre. Cambiar algo viejo cambia todos los hashes siguientes. Por eso reescribir historia compartida causa tantos problemas.
HEAD, ramas y el "detached HEAD"
HEAD es un puntero que dice dónde estás parado.
Normalmente HEAD apunta a una rama, y la rama apunta a un commit. Cuando hacés un commit nuevo, la rama avanza y HEAD va con ella.
Si hacés checkout de un commit directamente, HEAD apunta al commit sin pasar por una rama. Eso es el famoso "detached HEAD". No está roto: simplemente, si hacés commits ahí y te vas, esos commits no tienen ninguna rama que los sostenga. Por eso el aviso.
El comando que salva el día
Este solo dato justifica todo el artículo.
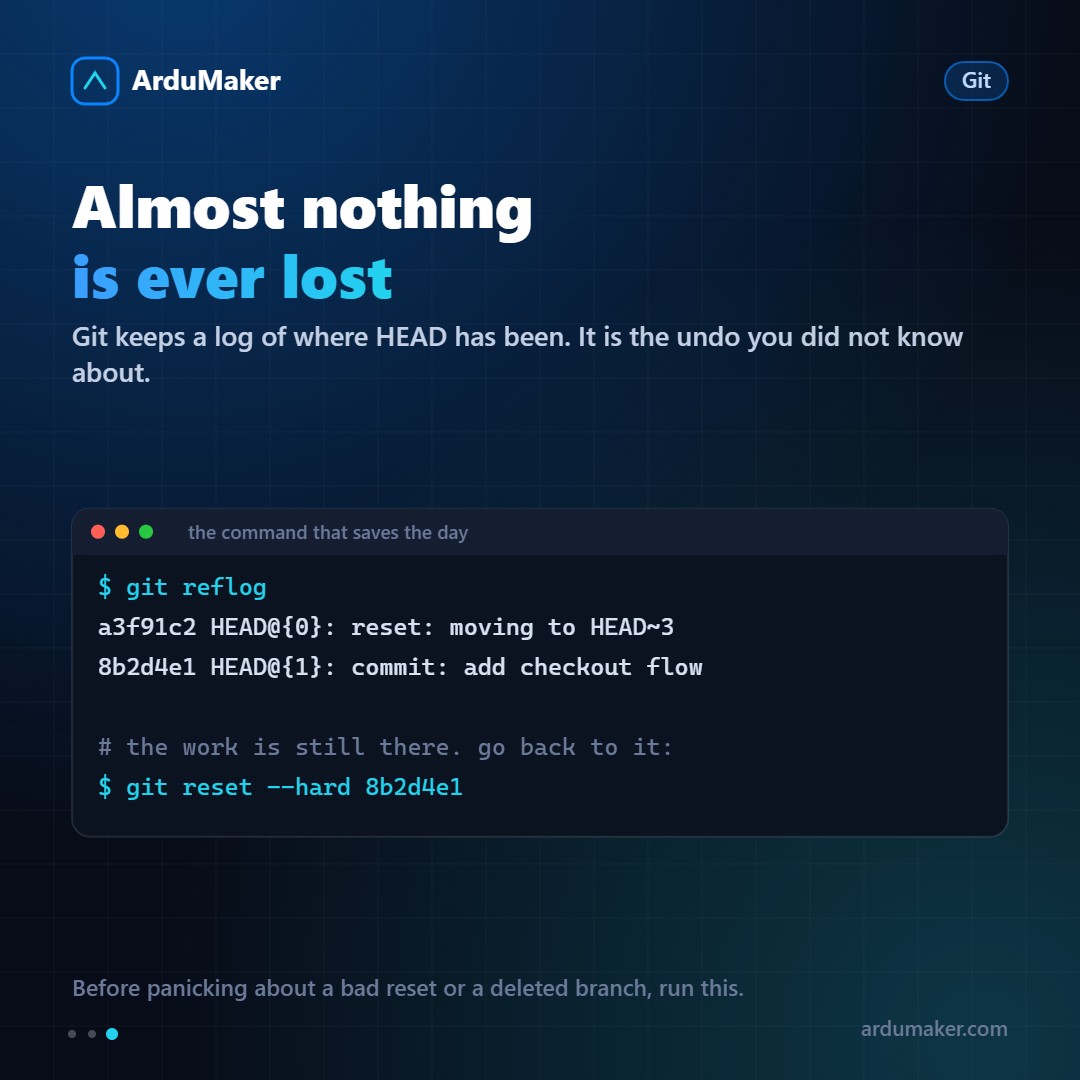
Git lleva un registro de todas las posiciones por las que pasó HEAD: el reflog.
git reflog
Si hiciste un reset que no debías, si borraste una rama por error, si te perdiste en medio de un rebase, ahí está la lista de dónde estuviste, con su hash. Volver es:
git reset --hard <hash>
Los commits huérfanos siguen en el repositorio durante semanas antes de que el recolector de basura los limpie. Casi nada se pierde de verdad en Git. Lo que se pierde son los cambios que nunca se confirmaron, y para eso está la costumbre de hacer commits chicos y frecuentes.
Lo que conviene tener en la cabeza
- Un commit es una foto con un puntero al padre.
- Una rama es un puntero a un commit, y es gratis.
- HEAD dice dónde estás.
- El reflog recuerda dónde estuviste.
Con eso, los comandos dejan de ser fórmulas mágicas y pasan a ser operaciones que podés razonar.