Por qué el deploy es la parte más importante de tu proyecto
Publicado el 2026-09-12 por frfrand
El código que no está en producción no existe. Por qué un despliegue difícil deforma todo lo demás, qué significa que sea aburrido y cómo se llega ahí.
Hay una frase incómoda y bastante cierta: el código que no está en producción no existe. No importa lo bien escrito que esté, no importa que pase todos los tests. Hasta que alguien lo usa, es una intención.
Por eso el mecanismo que lleva tu código desde tu máquina hasta el usuario merece más atención de la que suele recibir.
El círculo vicioso
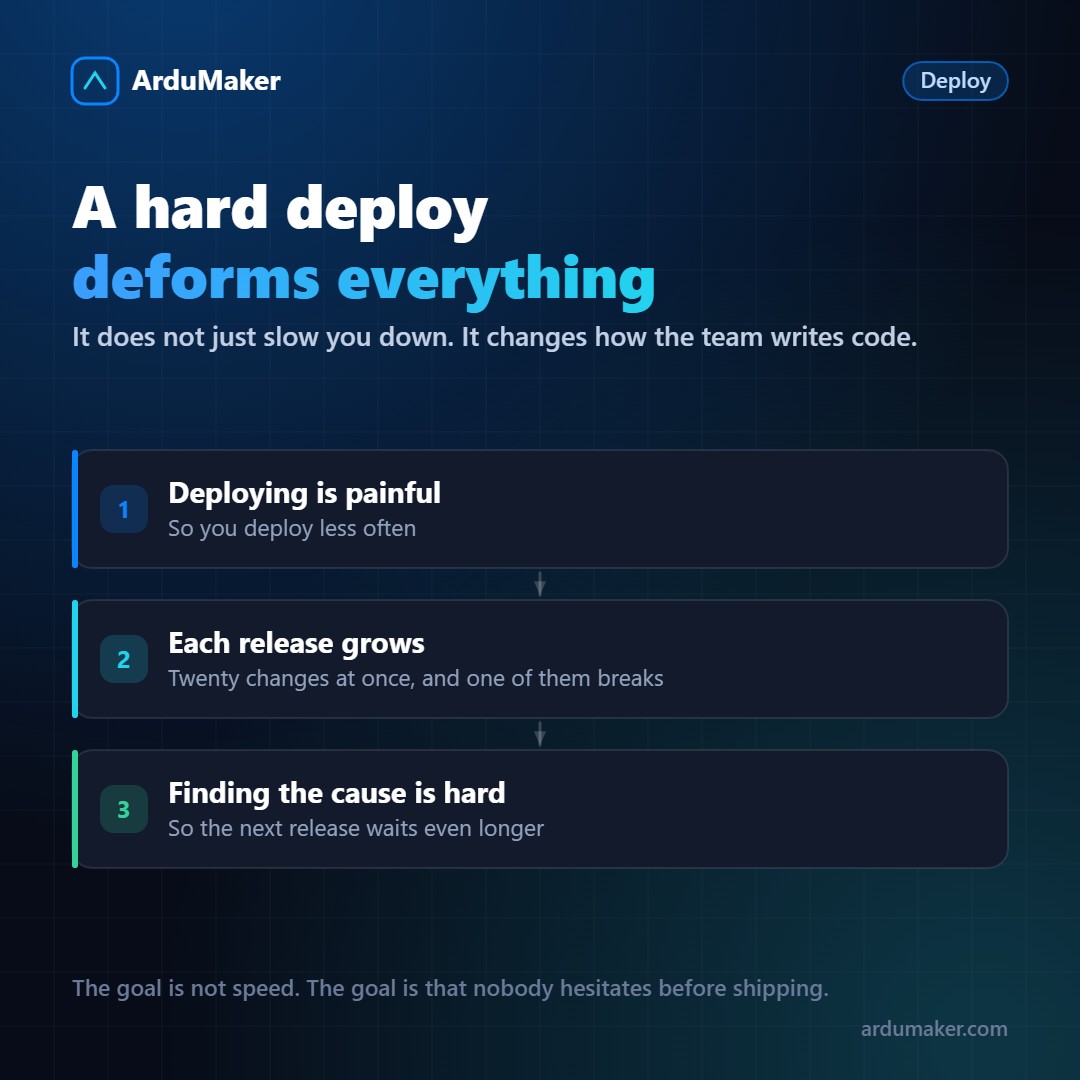
Lo interesante de un despliegue difícil es que no sólo te hace perder tiempo: deforma cómo trabaja el equipo.
Si publicar cuesta, se publica menos seguido. Si se publica menos seguido, cada entrega acumula más cambios. Si cada entrega tiene veinte cambios y algo se rompe, encontrar cuál fue lleva mucho más tiempo. Y como la última entrega fue traumática, la siguiente se pospone.
Es un círculo que se retroalimenta, y casi siempre se diagnostica mal: se le echa la culpa al código, a la falta de tests o al equipo, cuando el problema estaba en la fricción de publicar.
El corolario es contraintuitivo: publicar más seguido suele ser más seguro, no menos. Un despliegue de tres cambios se revierte fácil y se diagnostica rápido.
Qué significa que sea aburrido
Un buen despliegue tiene cuatro propiedades, y ninguna tiene que ver con velocidad:
Automático. Nadie ejecuta pasos a mano. Los pasos manuales se olvidan, sobre todo el viernes a las siete.
Repetible. El mismo commit produce el mismo resultado. Si el despliegue depende de qué había instalado en el servidor ese día, no es repetible.
Observable. Cuando falla, el log dice en qué paso. Un despliegue que falla en silencio es peor que uno que no existe.
Reversible. Tenés que poder volver a la versión anterior en minutos, sin pensar. Y eso se prueba antes de necesitarlo.
Los tres pasos que siempre están
Debajo de cualquier herramienta, un despliegue web hace lo mismo:
- Traer el código nuevo al servidor.
- Construir: instalar dependencias, compilar, aplicar migraciones.
- Reiniciar el servicio para que tome la versión nueva.
Cuando algo falla, falla en una de esas tres uniones. Saberlo acorta muchísimo el diagnóstico. Y casi siempre es la tercera, el reinicio: el servicio no levantó, o levantó con la configuración vieja.
El hueco del reinicio
Entre que se apaga el proceso viejo y responde el nuevo hay unos segundos en que nadie atiende. El usuario ve un error 502.
La forma de evitarlo es invertir el orden: levantar la versión nueva, esperar a que responda, mandarle el tráfico y recién ahí apagar la vieja. Para eso sirve tener un endpoint de salud que diga "ya estoy lista de verdad", y no sólo "el proceso existe".
Lo más difícil no es el código
Volver atrás en el código es fácil: revertir el commit y desplegar.
La base de datos es otra cosa. Una migración que borró una columna no se deshace con un redeploy.
Por eso conviene el orden: primero agregar lo nuevo, después que el código lo use, y borrar lo viejo recién varios días más tarde, cuando ya estás seguro. Así siempre existe una versión anterior del código que sigue funcionando contra la base actual.
A dónde llegar
La meta no es tener el despliegue más rápido. Es que nadie dude antes de publicar.
Cuando publicar es aburrido, el equipo entrega en pedazos chicos, los errores se encuentran solos y el tiempo se va en el producto y no en la ceremonia.
En ArduMaker ese camino se configura una vez desde el panel: repositorio, rama, comandos de build y dominio. Cada push ejecuta los tres pasos y deja su log, así que cuando algo se corta se ve exactamente en cuál.