De git push a producción: el camino completo, paso a paso
Publicado el 2026-09-12 por frfrand
Qué pasa exactamente entre que subís un commit y tu sitio se actualiza, cuáles son los tres puntos donde se rompe, y cómo leer los logs para saber cuál fue.
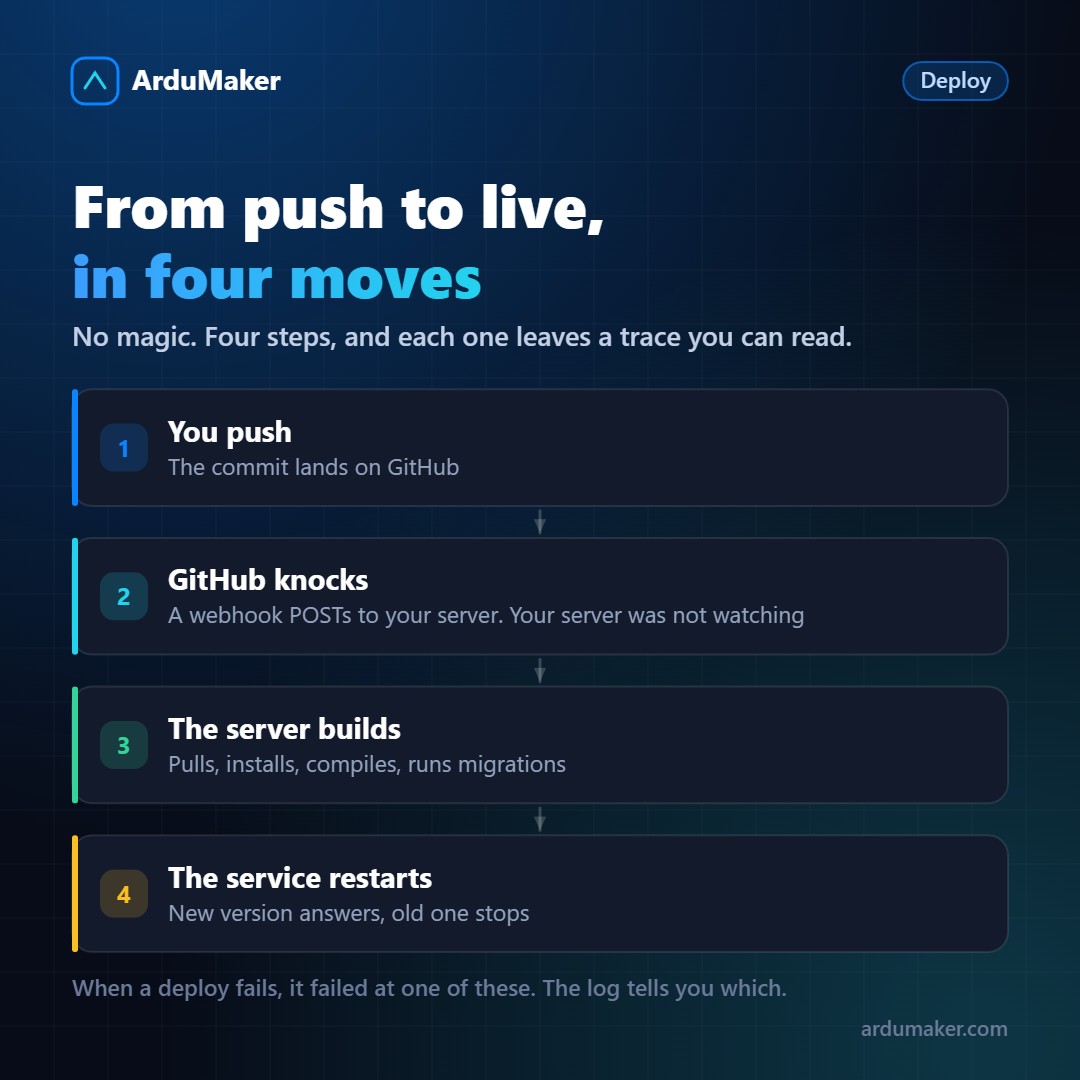
Hacés git push, esperás treinta segundos y tu sitio está actualizado. Lo que pasa en el medio son cuatro pasos bien concretos, y conocerlos convierte "no funcionó el deploy" en un diagnóstico de dos minutos.
Paso 1: el commit llega al repositorio
Tu push manda los objetos nuevos al remoto. Hasta acá nada tiene que ver con tu servidor.
Si el push falló, el problema es de Git o de permisos, y ni siquiera empezó un despliegue.
Paso 2: GitHub golpea la puerta
Acá está el detalle que más confunde a quien empieza: tu servidor no revisa GitHub cada tanto. Sería un desperdicio y llegaría tarde.
Es al revés: GitHub manda una petición HTTP a una dirección tuya. Eso es un webhook.
Tu servidor recibe ese mensaje, comprueba que venga firmado con el secreto compartido (si no, cualquiera podría disparar despliegues) y recién ahí empieza a trabajar.
Cómo diagnosticar este paso: GitHub guarda el historial de cada webhook con su respuesta. Si el despliegue no arrancó, ese historial lo dice todo. Un 404 significa que la dirección está mal. Un 500, que tu receptor falló. Un tiempo de espera agotado, que el servidor no contestó.
Este es el primer lugar donde mirar, y el que más veces resuelve el problema.
Paso 3: el servidor construye
El servidor baja el código y ejecuta los comandos de construcción del proyecto:
git pull npm install && npm run build # o pip install -r requirements.txt python manage.py migrate # si hay migraciones
Es el paso más largo y el que más falla, casi siempre por dos motivos:
- Una dependencia nueva que está en tu máquina y no se instaló en el servidor.
- Memoria. Compilar un frontend moderno consume bastante RAM, y en un VPS chico el proceso puede morir a mitad de camino. El síntoma es un log que se corta de golpe, sin error claro. Si ves eso, mirá si el sistema mató el proceso por falta de memoria.
Una decisión que vale considerar: construir en el servidor es simple y no necesita infraestructura extra, pero consume recursos del mismo servidor que atiende a los usuarios. Construir afuera y subir el resultado ya compilado es más liviano en producción, al costo de más piezas.
Paso 4: el servicio se reinicia
El código nuevo está en disco, pero el proceso que corre sigue siendo el viejo, con el código anterior cargado en memoria. Hay que reiniciarlo:
systemctl restart miapp
Y acá aparece el hueco: entre que muere el proceso viejo y responde el nuevo pasan entre dos y diez segundos donde nadie atiende. El usuario ve un 502.
Para evitarlo hay que invertir el orden: levantar la versión nueva, esperar a que conteste, mandarle el tráfico y recién ahí apagar la vieja. Para eso conviene tener una ruta de salud que diga "ya estoy lista de verdad".
Si tu sitio es estático, este paso ni existe: los archivos nuevos ya están en disco y nginx los sirve.
El resumen que vale tener a mano
- No se disparó nada → el webhook. Mirá el historial de entregas en GitHub.
- Se disparó y falló → el log del build. Dependencias o memoria.
- Terminó bien pero el sitio sigue igual → no se reinició el servicio, o hay caché adelante.
- 502 justo después de publicar → es el hueco del reinicio. Si dura, la app no levantó: mirá su log.
En ArduMaker estos cuatro pasos se configuran una vez desde el panel (repositorio, rama, comandos, dominio) y cada despliegue queda con su log completo, así que la pregunta "¿en cuál de los cuatro se cortó?" se contesta mirando, no adivinando.