Cómo y dónde se guardan los logs en un servidor
Publicado el 2026-09-12 por frfrand
Dónde busca cada cosa, qué cambió con journald, por qué un log sin rotación llena el disco, y los comandos que resuelven la mayoría de las búsquedas.
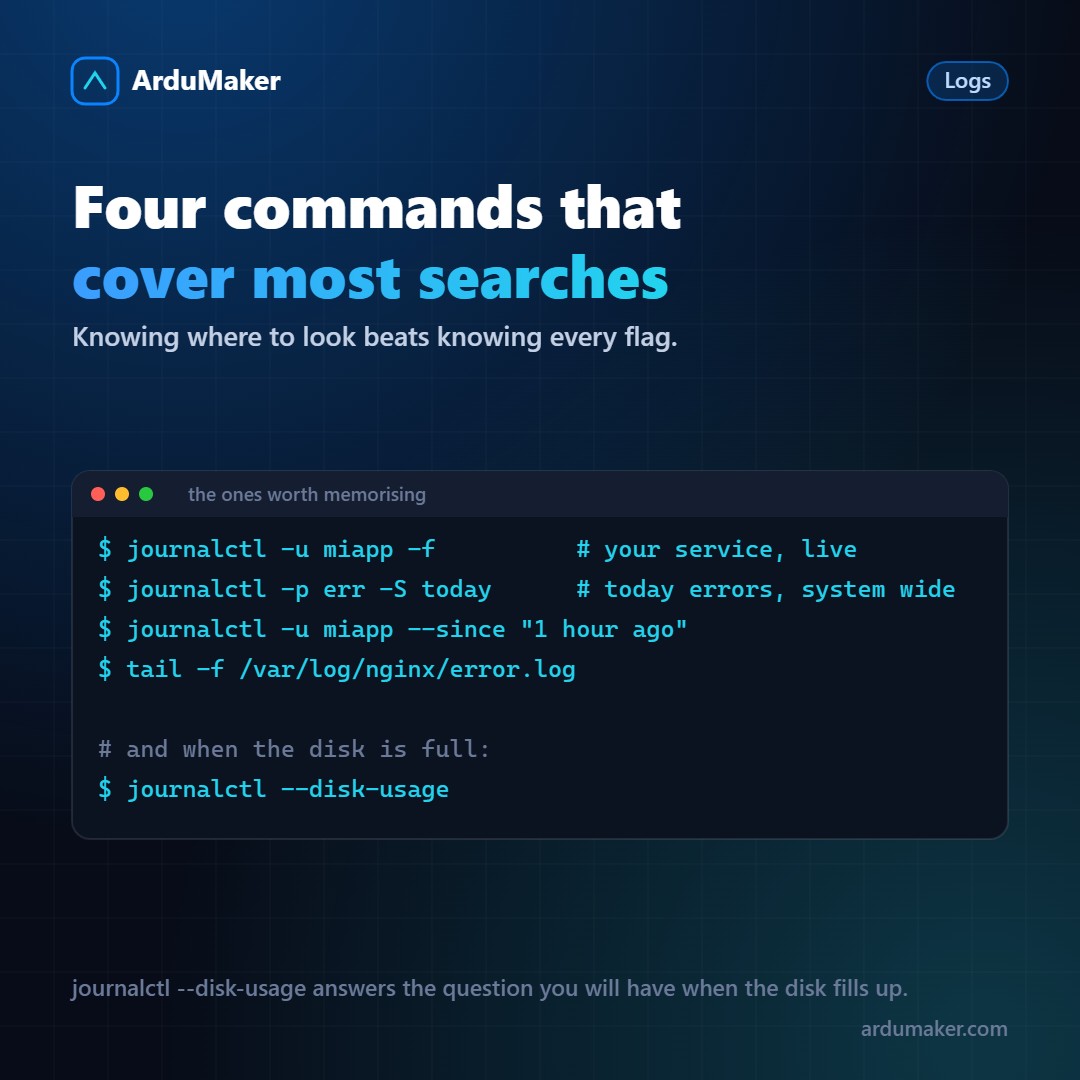
Cuando algo falla, la respuesta casi siempre ya está escrita en algún lado. El problema es saber en cuál.
Dos sistemas conviviendo
En un Linux moderno hay dos lugares donde van los registros, y conviene entender la diferencia.
journald (de systemd) guarda en un formato binario indexado, con metadatos: de qué servicio viene cada línea, qué usuario, qué proceso, con qué prioridad. Se consulta con journalctl.
Los archivos de texto en /var/log siguen existiendo. Muchos servicios (nginx, por ejemplo) escriben sus propios archivos directamente, y en muchas distribuciones rsyslog copia parte del journal a archivos por compatibilidad.
Esa duplicación explica una confusión frecuente: el mismo mensaje puede aparecer en los dos lados.
Los comandos que vale memorizar
Para un servicio:
journalctl -u miapp -f # en vivo journalctl -u miapp --since "1 hour ago" journalctl -u miapp -n 200 # las últimas 200 líneas
Para errores del sistema:
journalctl -p err -S today
La opción -p filtra por prioridad, con la escala clásica de syslog: 0 emergencia, 3 error, 4 advertencia, 6 informativo. Filtrar por err deja fuera el ruido y muestra lo que importa.
Y para los archivos de texto:
tail -f /var/log/nginx/error.log grep -i "timeout" /var/log/nginx/error.log | tail -50
Un atajo que ahorra tiempo
Si nginx devuelve 502, el problema casi nunca está en nginx: significa que tu aplicación no respondió. El error está en el log de tu aplicación, no en el de nginx.
Un 504 es distinto: tu aplicación sí respondió, pero tardó más de lo que nginx esperaba.
Saber esa diferencia ahorra muchas búsquedas en el archivo equivocado.
La rotación, y por qué el disco se llena
Un log crece indefinidamente si nadie lo corta. La rotación se ocupa de eso: renombra el archivo, empieza uno nuevo, comprime los viejos y borra los que superan la retención.
Para los archivos de texto lo hace logrotate, con su configuración en /etc/logrotate.d/. Cada servicio deja ahí su archivo.
Para el journal, el límite se configura en /etc/systemd/journald.conf:
SystemMaxUse=500M
Sin ese límite, el journal puede crecer hasta ocupar un porcentaje considerable del disco.
Y el comando que vas a querer el día que el disco se llene:
journalctl --disk-usage journalctl --vacuum-time=7d # borra lo anterior a 7 días
Dos detalles que muerden
Un log rotado mientras un proceso lo tiene abierto. Si la rotación renombra el archivo y el proceso sigue escribiendo en el descriptor viejo, el espacio no se libera y las líneas nuevas van a un archivo sin nombre. Por eso la configuración de rotación incluye avisar al proceso para que reabra sus archivos. Cuando ves que el disco no se libera después de rotar, suele ser esto.
Los logs de las aplicaciones en contenedores no van al journal por defecto: los captura el motor de contenedores. Si no configurás rotación ahí, esos archivos crecen sin control. Es una causa muy frecuente de discos llenos en servidores con Docker.
Qué conviene registrar
Más no es mejor. Un log con todo es tan inútil como uno vacío, porque nadie lo lee.
Tres costumbres que hacen que los logs sirvan:
- Un identificador por petición, que aparezca en todas las líneas relacionadas. Permite reconstruir qué pasó en un caso concreto.
- Formato estructurado (JSON) si vas a procesarlos con herramientas. Texto plano si los vas a leer con los ojos.
- Nunca datos sensibles. Contraseñas, tokens y datos personales no van al log. Es una de las formas más comunes de filtración, y pasa casi siempre por una sesión de depuración que quedó encendida.
En ArduMaker los logs de cada servicio y de cada despliegue se ven desde el panel, con su historial, sin tener que entrar por SSH a buscarlos.