Cómo se mide el trabajo de un servidor sin volverse loco
Publicado el 2026-09-12 por frfrand
Cuatro números que dicen casi todo, qué significa realmente el load average, por qué el uso de CPU engaña, y en qué orden mirar cuando algo va lento.
Un servidor va lento. Abrís cuatro herramientas, ves números, y no queda claro cuál mirar. El problema no es la falta de datos: es el orden.
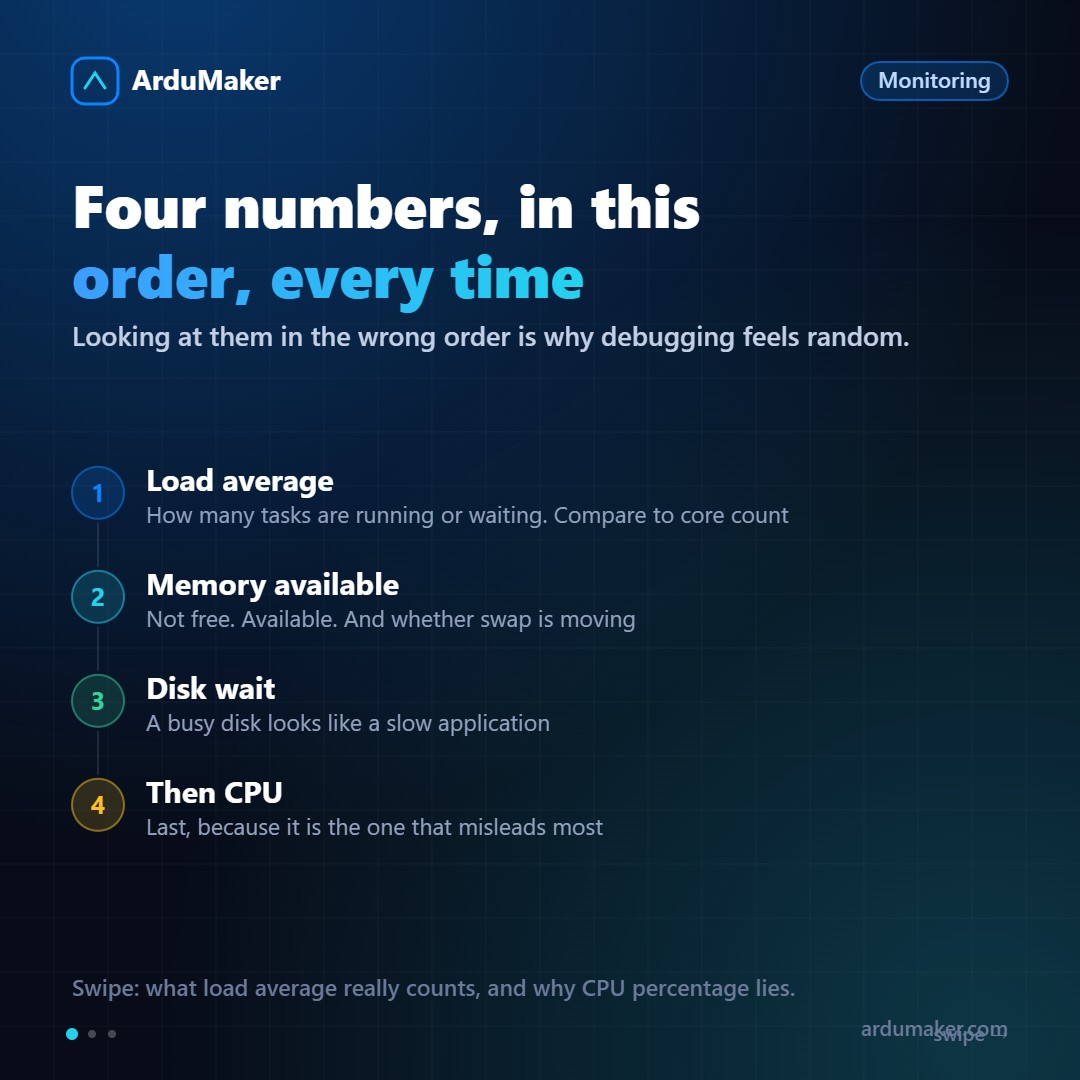
Estos son los cuatro números, en el orden en que conviene leerlos.
1. El promedio de carga (load average)
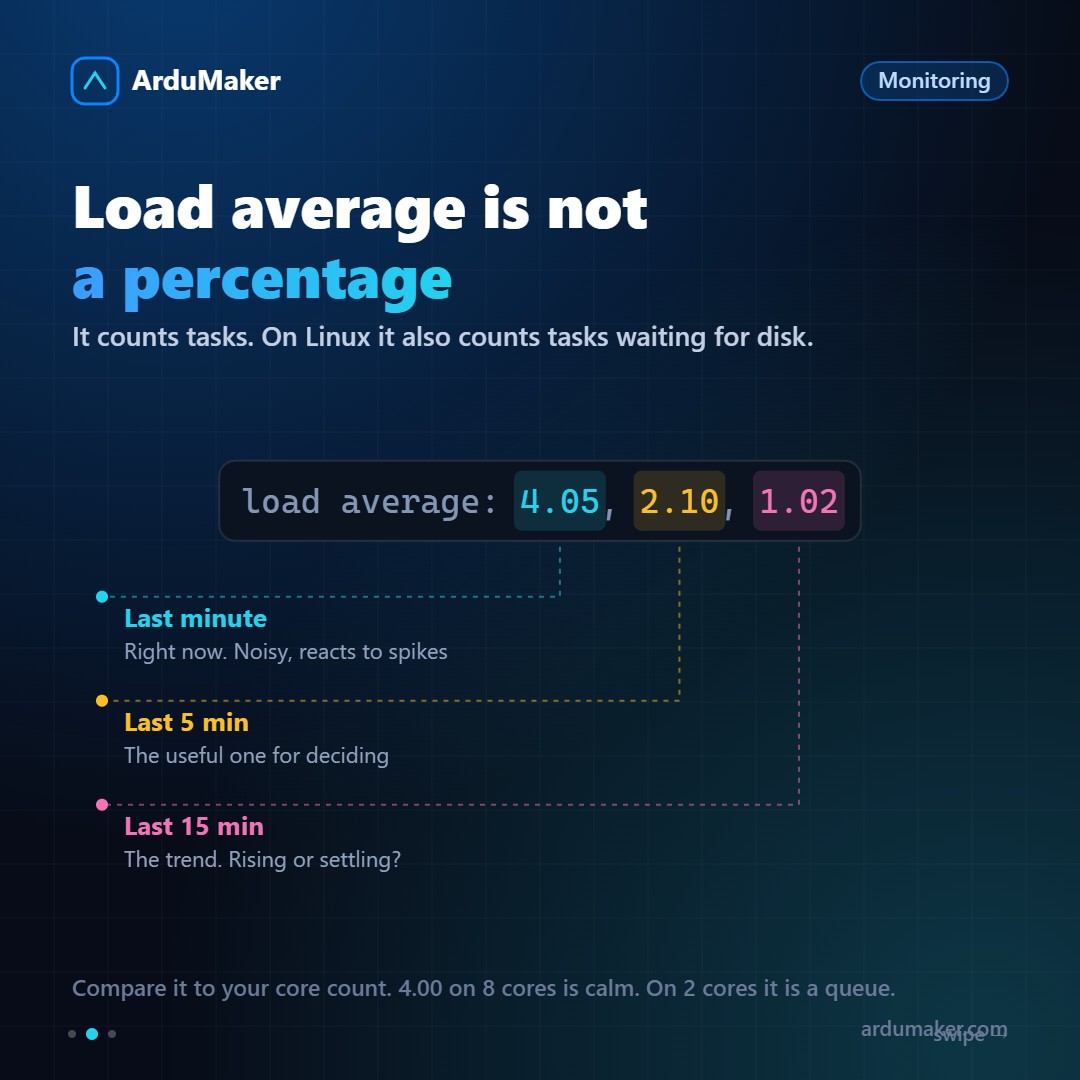
$ uptime load average: 4.05, 2.10, 1.02
Los tres valores son el promedio del último minuto, los últimos cinco y los últimos quince.
Lo primero: no es un porcentaje. Cuenta tareas que están ejecutándose o esperando turno. Un valor de 4 significa "hay cuatro tareas queriendo correr en promedio".
Para interpretarlo hay que compararlo con la cantidad de núcleos:
- 4.00 en una máquina de 8 núcleos: tranquila, sobra capacidad.
- 4.00 en una máquina de 2 núcleos: hay cola, las tareas esperan.
Y una particularidad de Linux que confunde a mucha gente: también cuenta las tareas esperando al disco. Por eso un servidor con un disco saturado puede mostrar carga altísima con el procesador casi ocioso. No es un error de medición: describe correctamente que hay trabajo trabado.
Los tres números juntos cuentan una historia: si el de un minuto es mucho mayor que el de quince, algo acaba de empezar. Si es al revés, ya está bajando.
2. La memoria
$ free -h
La columna a mirar es available, no "free".
Que "free" sea bajo es normal y bueno: Linux usa la memoria sobrante como caché de disco, y la libera cuando alguien la necesita. Un servidor con mucha memoria "libre" está desaprovechándola.
Lo que sí importa: si "available" está bajo y la swap tiene movimiento. Eso se ve con:
$ vmstat 1
Las columnas "si" y "so" (entrada y salida de swap). Si hay actividad constante ahí, el servidor está pasando datos a disco porque no le entra en memoria, y la latencia se multiplica por mil.
3. El disco
$ iostat -x 1
Dos cosas: el porcentaje de utilización y el tiempo de espera. Un disco al 100% con esperas altas es el cuello de botella, y se ve desde afuera como "la aplicación está lenta".
Este es el número que más se saltea, y el que más veces resulta ser la causa.
4. El procesador, al final
$ top
Se deja para el final porque es el que más engaña.
Un servidor al 100% de CPU puede estar perfectamente bien: está usando lo que pagaste. Y un servidor al 20% puede estar arrastrándose, porque está esperando disco o red.
Dentro de top, la columna que más información da es "wa" (tiempo de espera de entrada/salida). Si es alta, el procesador está esperando al disco: el problema no es el procesador.
Y "st" (tiempo robado): el hipervisor le está dando tus turnos a otro. Si es alta y consistente, estás compitiendo con vecinos.
El número que casi nadie mide
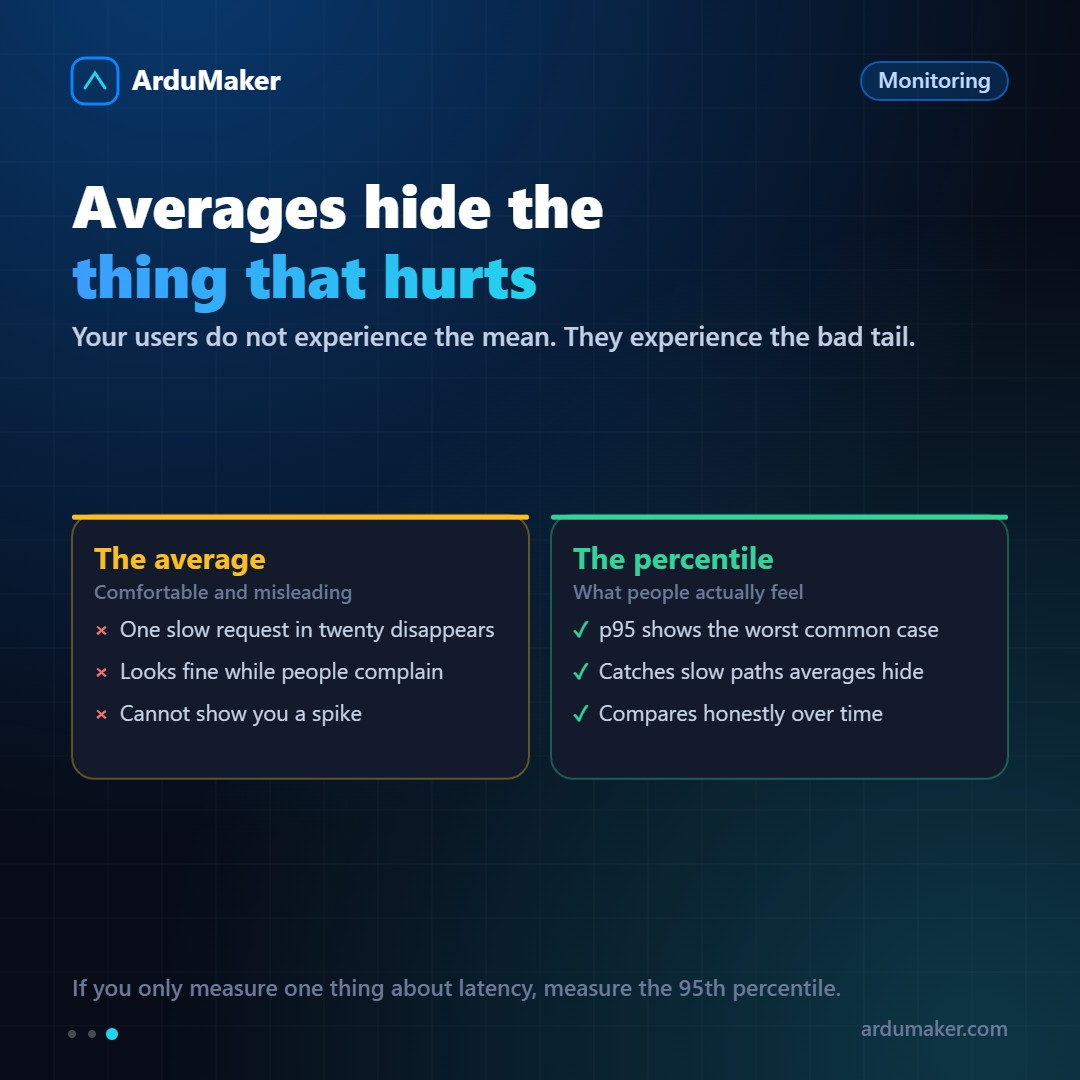
Los promedios esconden justamente lo que duele.
Si una de cada veinte peticiones tarda cinco segundos y el resto cien milisegundos, el promedio se ve bien y hay usuarios enojados.
Por eso conviene medir percentiles. El percentil 95 dice: el 95% de las peticiones fue más rápido que este valor. Es el peor caso común, y es lo que la gente siente.
Si vas a medir una sola cosa sobre la latencia de tu aplicación, medí el percentil 95.
Y lo que da sentido a todo
Un número sin historia no sirve. Saber que la carga es 3 no dice nada; saber que hace una semana era 0,8 lo dice todo.
Por eso el monitoreo con historial vale más que cualquier panel instantáneo. En ArduMaker el sistema de estado revisa hosts, VPS y dominios en ciclo continuo y guarda 45 días de histórico, que es lo que permite contestar "¿esto viene pasando hace cuánto?" en vez de mirar un número suelto.