Cómo creció Internet: de 4 nodos a todo el planeta
Publicado el 2026-09-12 por frfrand
Qué decisión de diseño permitió que escalara sin que nadie la coordinara, por qué TCP/IP le ganó a alternativas mejor financiadas, y qué se rompió por el camino.
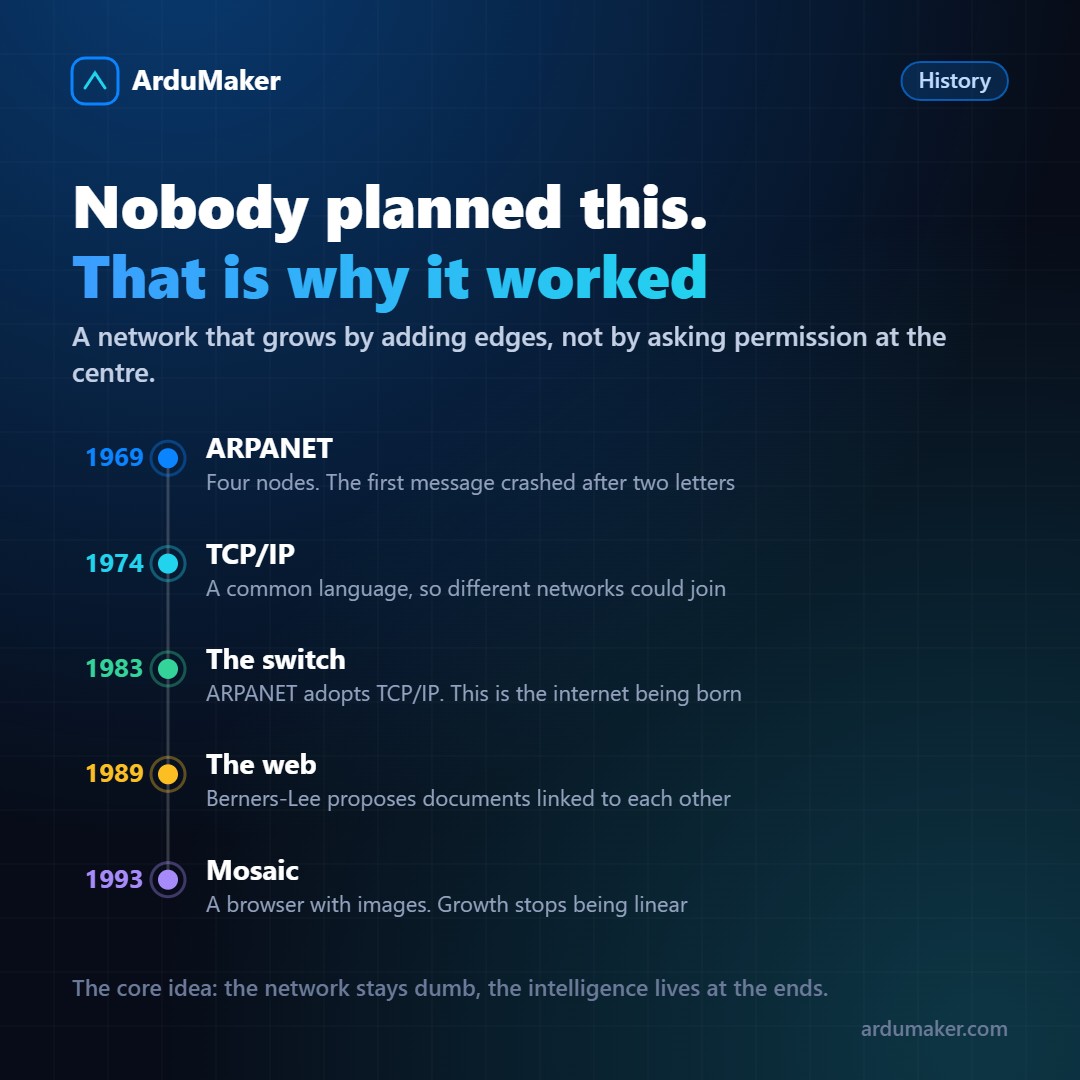
En 1969 ARPANET tenía cuatro nodos. El primer mensaje que se intentó enviar fue la palabra "login", y el sistema se cayó después de las dos primeras letras.
Cincuenta y pico de años después hay miles de millones de dispositivos conectados. Lo interesante no es el crecimiento: es que nadie lo coordinó.
La decisión de diseño que lo permitió
Las redes de telecomunicaciones de la época eran inteligentes en el centro: la red sabía quién hablaba con quién, reservaba un circuito y lo mantenía. Los extremos eran tontos, como un teléfono.
Internet hizo lo contrario: la red es tonta y los extremos son inteligentes.
Los routers no saben qué transportan. No reservan nada, no garantizan que llegue, no verifican el orden. Sólo miran la dirección de destino y lo pasan al siguiente salto, "lo mejor que puedan".
Todo lo demás (reordenar, detectar lo perdido, reintentar, controlar la velocidad) lo hacen las computadoras de los extremos, con TCP.
Esa elección tiene una consecuencia enorme: para agregar algo nuevo no hay que pedirle permiso a la red. La web, el correo, el vídeo, las videollamadas y todo lo que venga funcionan sin cambiar un solo router. Si la inteligencia estuviera en el centro, cada aplicación nueva habría requerido actualizar la infraestructura del mundo.
Por qué ganó TCP/IP
No era el único candidato, y sobre el papel no era el mejor. Había un conjunto de protocolos respaldado por organismos internacionales y grandes empresas de telecomunicaciones, con un diseño más completo y formal.
TCP/IP ganó por tres razones muy poco glamorosas:
Estaba implementado y funcionaba. Mientras la alternativa se discutía en comités, TCP/IP ya movía paquetes.
Venía con Unix. La implementación de Berkeley se distribuyó con el sistema operativo que usaban las universidades. Gratis y ya instalado.
El proceso era abierto. Las especificaciones se publicaban como RFC, cualquiera podía leerlas e implementarlas, y se avanzaba con lo que funcionaba en la práctica. La frase que resume la cultura de esa comunidad: consenso aproximado y código que funciona.
El nombre, y por qué hizo falta
Recordar direcciones numéricas no escala. En los primeros años había un único archivo de texto con todos los nombres y sus direcciones, que se distribuía a mano entre las máquinas conectadas.
Eso dejó de funcionar rápido, y en 1983 apareció el DNS: un sistema jerárquico y distribuido donde cada dominio es responsable de sus propios nombres.
Es la misma idea de siempre: en vez de un registro central que todos copian, una estructura donde cada parte administra lo suyo.
La web, que no es Internet
Vale la distinción porque se usan como sinónimos.
Internet es la red: el transporte de paquetes. Existía hacía veinte años y ya llevaba correo, transferencias de archivos y foros.
La web es una aplicación encima de Internet: documentos con enlaces entre sí, propuesta por Tim Berners-Lee en 1989.
Lo que la hizo explotar fue el navegador con imágenes, en 1993. Ahí el crecimiento dejó de ser lineal.
Qué se rompió por el camino
Ser honestos sobre esto es parte de entenderlo:
Las direcciones se agotaron. Cuatro mil millones parecían infinitas en 1981.
No se pensó en la seguridad. Todo viajaba en claro, porque la red era entre gente que se conocía. Todo lo que vino después (HTTPS, SSH, certificados) son capas agregadas sobre un cimiento que asumía buena fe.
Se centralizó de otra manera. Técnicamente sigue siendo descentralizada, pero en la práctica una porción enorme del tráfico pasa por muy pocas empresas. La caída de un solo proveedor puede dejar sin servicio a medio mundo, algo que el diseño original quería evitar.
Ninguna de esas tres cosas contradice lo anterior. Son el precio de haber escalado más de lo que nadie imaginó.