Por qué existen tantos tipos de bases de datos
Publicado el 2026-09-12 por frfrand
No es moda: cada familia optimiza algo distinto y paga por ello en otro lado. Relacionales, documentos, clave-valor, columnares, grafos y series temporales, con el caso donde cada una gana.
Hace veinte años la respuesta era una sola: base relacional. Hoy hay decenas de opciones y la elección genera discusiones enteras.
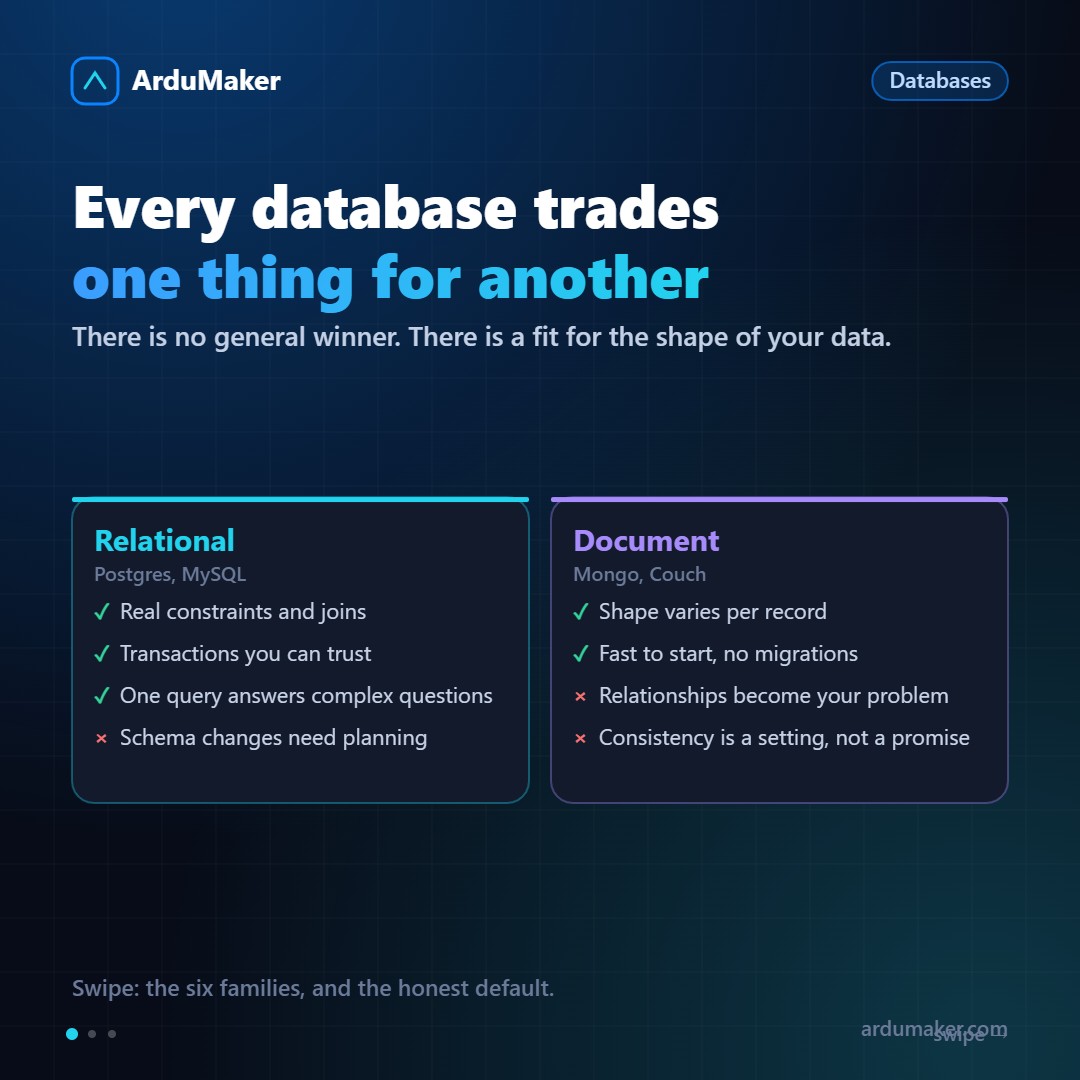
La razón no es moda. Es que cada familia de bases optimiza algo distinto, y lo paga en otro lado. Conocer el intercambio de cada una convierte la discusión en una decisión.
Relacionales
Datos en tablas con relaciones explícitas. Postgres, MySQL, SQLite.
Optimizan: integridad y consultas complejas. Podés preguntar "todos los clientes que compraron más de tres veces el mes pasado y no volvieron" en una sola consulta, y confiar en el resultado.
Pagan: el esquema es rígido. Cambiarlo requiere una migración pensada.
De documentos
Guardan objetos completos, tipo JSON. MongoDB, CouchDB.
Optimizan: flexibilidad de forma. Cada registro puede tener campos distintos, y no hay migración para agregar uno.
Pagan: las relaciones pasan a ser tu problema. Sin joins reales, terminás haciendo varias consultas y uniendo en la aplicación, o duplicando datos y manteniéndolos sincronizados a mano.
Un apunte honesto: mucha gente eligió documentos por flexibilidad y terminó implementando a mano lo que una base relacional ya hacía. Y hoy Postgres guarda JSON indexable, lo que borró buena parte de la ventaja.
Clave-valor
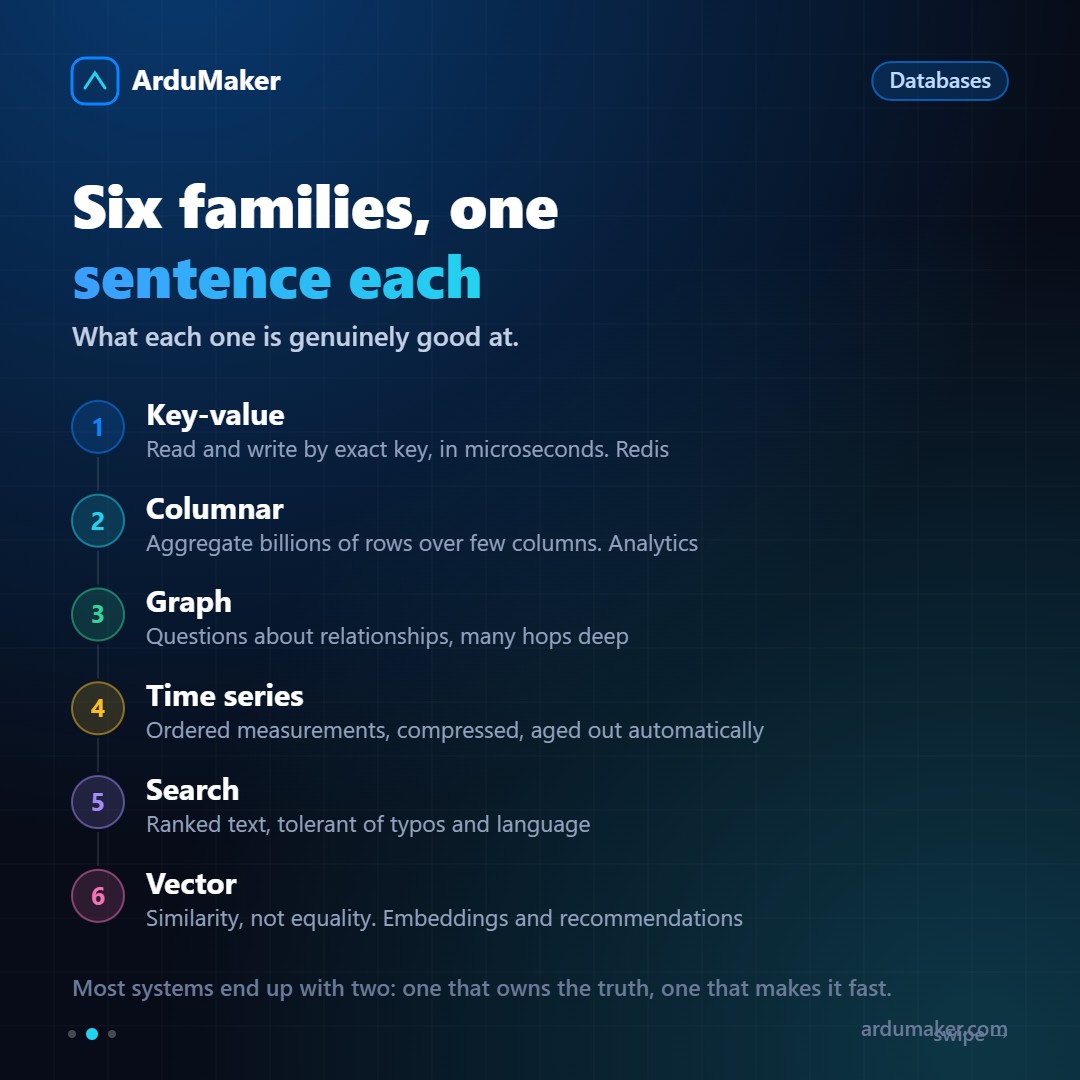
Una clave, un valor, acceso directísimo. Redis, Memcached.
Optimizan: velocidad. Lecturas y escrituras en microsegundos, porque viven en memoria.
Pagan: no hay consultas. Sólo puedes buscar por la clave exacta. Y si es solo memoria, un reinicio borra todo (Redis puede persistir, pero ese no es su punto fuerte).
Se usa casi siempre al lado de otra base, no en lugar de ella: caché, sesiones, colas, contadores, límites de peticiones.
Columnares
Guardan por columna en vez de por fila. ClickHouse, BigQuery.
Optimizan: agregaciones sobre muchísimas filas. "Promedio de ventas por región de los últimos tres años" sobre mil millones de registros, en segundos, porque solo leen las columnas que necesitan.
Pagan: son malas para el trabajo transaccional. Traer una fila completa o actualizar un registro es caro.
De grafos
Nodos y relaciones como ciudadanos de primera. Neo4j.
Optimizan: preguntas sobre relaciones a varios saltos. "Amigos de amigos que trabajaron en la misma empresa" es natural aquí y horrible en SQL.
Pagan: todo lo demás. Son especializadas.
Series temporales y búsqueda
Series temporales (InfluxDB, TimescaleDB): mediciones ordenadas por tiempo, comprimidas, con borrado automático de lo viejo. Métricas y sensores.
Búsqueda (Elasticsearch, OpenSearch): texto con relevancia, tolerancia a errores de tipeo, análisis por idioma. Un LIKE de SQL no se le acerca.
El default honesto
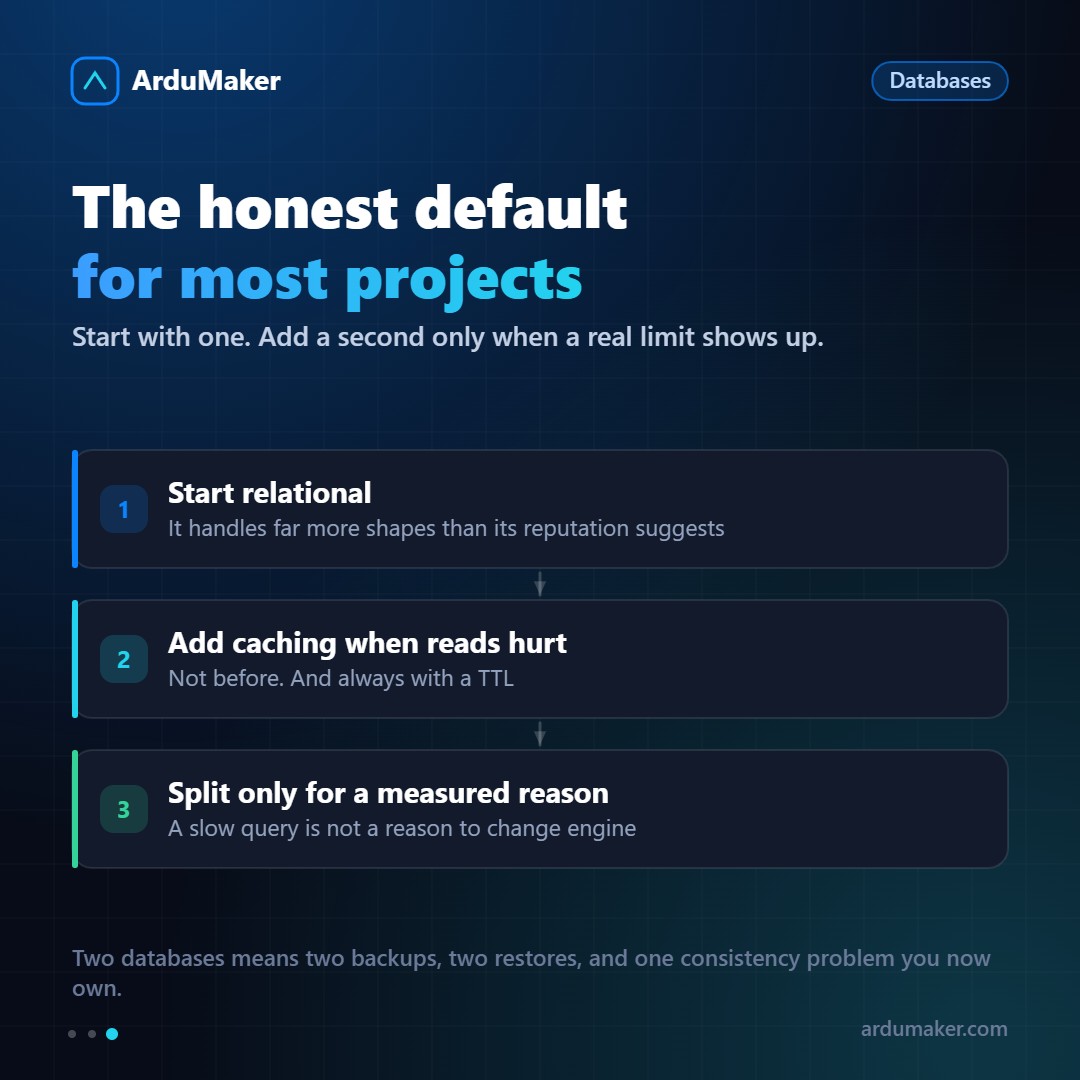
Para la mayoría de los proyectos: empieza con una base relacional. Maneja muchas más formas de datos de las que su fama sugiere, y resuelve integridad y consultas complejas que después es carísimo reimplementar.
Agrega una segunda solo cuando aparezca un límite medido. Y ten presente el costo real: dos bases son dos copias de seguridad, dos restauraciones que probar, y un problema de consistencia entre ambas que ahora es tuyo.
El patrón más común y más sano es: una base relacional que guarda la verdad, y Redis adelante para lo que se lee mucho.
¿Cómo elegir la base de datos para un proyecto real?
Para un catálogo con pedidos, clientes y pagos relacionados, PostgreSQL suele ser un buen punto de partida. Para caché de sesiones o resultados de consultas repetidas, Redis puede complementar esa base; no es una sustitución directa. Un motor documental puede tener sentido si los datos y las consultas favorecen ese modelo.
En ArduMaker podés administrar PostgreSQL, MySQL y Redis dentro del entorno de un VPS. Antes de elegir, escribí las consultas principales, estimá la cantidad de datos, decidí el esquema de backups y comprobá cómo migrarías a otro proveedor. La familiaridad del equipo y el mantenimiento son tan importantes como las funcionalidades del motor.
Relacionado: PostgreSQL explicado · Redis y sus usos.