Por qué el .env importa tanto y cómo tratarlo bien
Publicado el 2026-09-12 por frfrand
Las claves que más se filtran no se roban: se suben sin querer. Tres costumbres que evitan casi todos esos sustos, y qué hacer cuando una credencial ya estuvo en un commit.
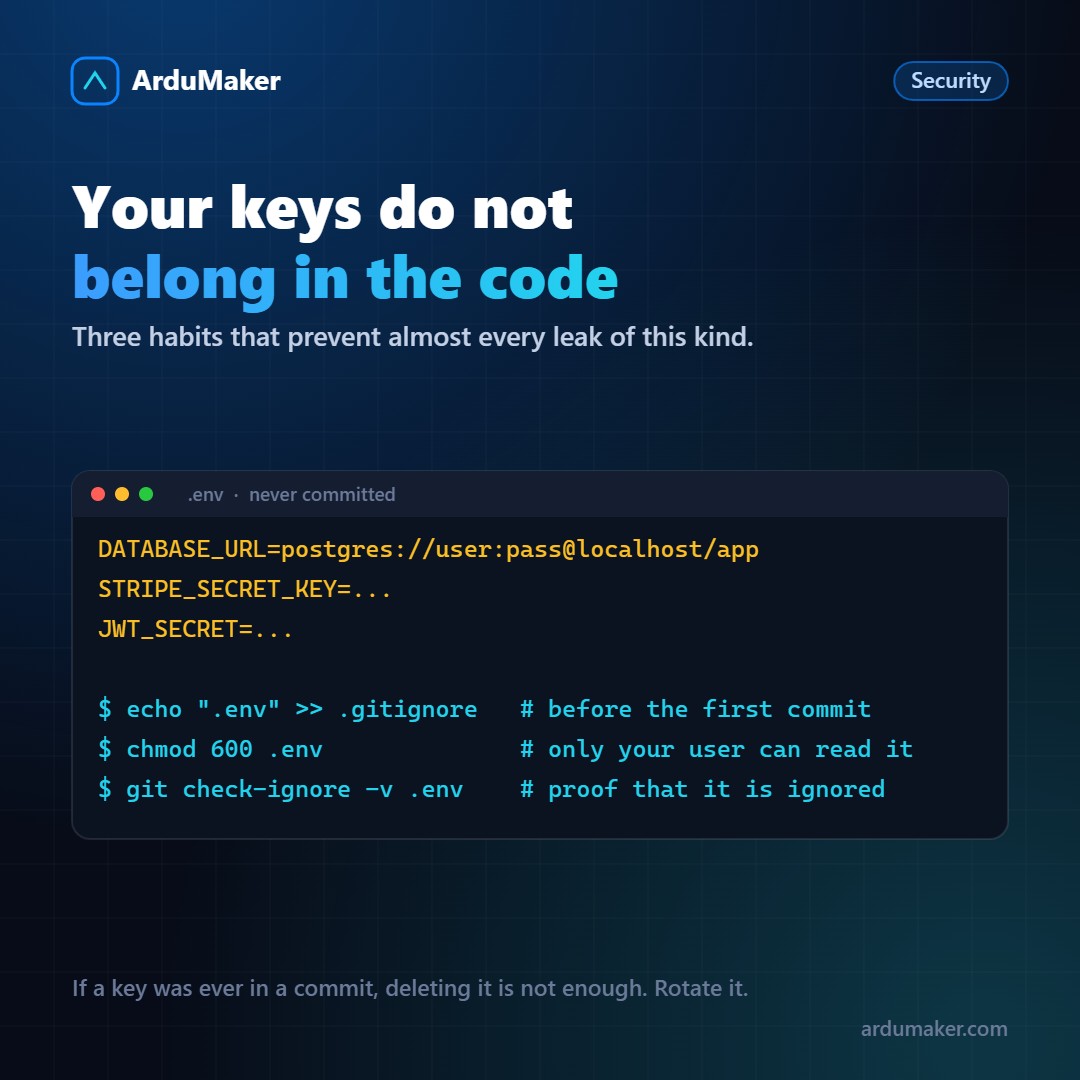
Las credenciales que más se filtran no se roban con un ataque sofisticado. Se suben a un repositorio sin querer.
Hay empresas enteras dedicadas a escanear repositorios públicos buscando claves. Una credencial de un proveedor de nube publicada por error se detecta y se usa en minutos, no en días.
Por qué existe el .env
La idea viene de una convención de diseño de aplicaciones: la configuración que cambia entre entornos no va en el código, va en el entorno.
El mismo código tiene que poder correr en tu máquina, en staging y en producción, cambiando sólo variables. Eso obliga a sacar del código todo lo que sea específico de un entorno: cadenas de conexión, claves de API, direcciones de servicios, secretos de firma.
El archivo .env es simplemente una forma cómoda de cargar esas variables cuando desarrollás. En producción, muchas veces ni siquiera hace falta el archivo: las variables las inyecta el sistema que corre tu servicio.
Las tres costumbres
1. .gitignore antes del primer commit.
echo ".env" >> .gitignore
El orden importa. Si lo agregás después, el archivo ya está en la historia y sacarlo de ahí es mucho más trabajo.
Una comprobación que vale la pena conocer:
git check-ignore -v .env
Si no imprime nada, no está ignorado, por más que creas que sí.
2. Permisos 600.
chmod 600 .env
Sólo tu usuario lo lee. En un servidor con varios usuarios o varios servicios, esto no es teórico: es lo que evita que el proceso de otra aplicación pueda leer tus credenciales.
3. Un .env.example versionado.
Un archivo con todas las claves y sin ningún valor:
DATABASE_URL= STRIPE_SECRET_KEY= JWT_SECRET=
Ese sí va al repositorio. Sirve de documentación viva de qué configuración necesita el proyecto, y evita el clásico de que alguien clone el repositorio y pierda dos horas descubriendo qué variables faltan.
Si una clave ya estuvo en un commit
Acá está el error más caro, porque parece resuelto y no lo está.
Borrar la clave del archivo y hacer un commit nuevo no sirve. La clave sigue en la historia del repositorio. Cualquiera que tenga el repositorio, o que lo clone si es público, puede recuperarla con un comando.
Lo único que resuelve de verdad es rotar la credencial: generar una nueva y revocar la vieja.
Reescribir la historia (con git filter-repo o similar) puede ser deseable además, sobre todo si el repositorio es público, pero es lo secundario. Mientras la credencial vieja siga siendo válida, el problema existe.
Orden correcto: rotar primero, limpiar después.
Un par de cosas más
No todo secreto es una variable de entorno. Para equipos grandes o requisitos más estrictos existen gestores de secretos, con rotación automática y registro de accesos. Para la mayoría de los proyectos, variables de entorno bien tratadas alcanzan.
Cuidado con los logs. Es fácil, en una sesión de depuración, imprimir toda la configuración y que eso quede en un archivo de log que después se comparte.
Cuidado con el frontend. Cualquier variable que termine en el paquete que se manda al navegador es pública, por más que se llame SECRET. Si tiene que ser secreto, vive en el backend.
En ArduMaker las variables de entorno de un despliegue se configuran desde el panel y viajan al servicio sin quedar escritas en el repositorio ni en el historial de comandos.