Cómo se gestionan los procesos hijos en Linux
Publicado el 2026-09-12 por frfrand
Qué hacen fork y exec, por qué existen los procesos zombis y qué significan realmente, quién adopta a los huérfanos, y por qué tu contenedor ignora la señal de apagado.
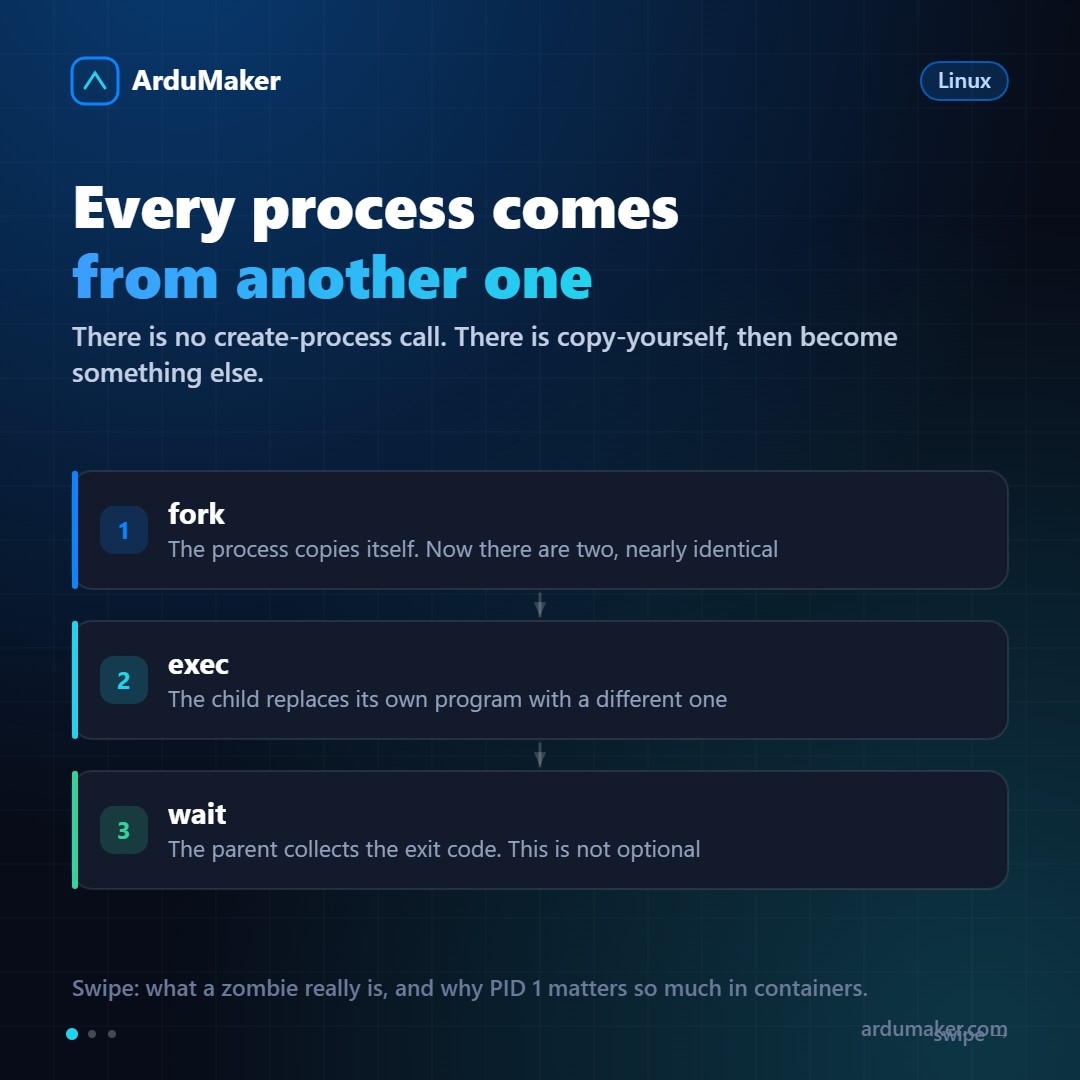
En Linux no existe una llamada para "crear un proceso desde cero". Existe una para copiarse a sí mismo, y otra para reemplazar el programa que estás ejecutando. Todo lo demás sale de combinar esas dos.
fork y exec
fork duplica el proceso actual. Después de la llamada hay dos procesos casi idénticos, con la misma memoria (compartida de forma inteligente hasta que alguno escriba) y los mismos archivos abiertos. La única diferencia es el valor que devuelve la llamada: al padre le devuelve el identificador del hijo, y al hijo le devuelve cero. Así cada uno sabe quién es.
exec reemplaza el programa del proceso actual por otro. No crea nada: el identificador sigue siendo el mismo, lo que cambia es el código que ejecuta.
Cuando tu shell corre un comando, hace exactamente eso: se copia con fork, y en la copia llama a exec con el programa que pediste.
Parece rebuscado y es muy potente: entre el fork y el exec, el hijo puede cambiar cosas (redirigir su entrada y salida, cambiar de usuario, ajustar límites). Ahí es donde se implementan las tuberías y las redirecciones del shell.
Los zombis, que están mal explicados en todos lados
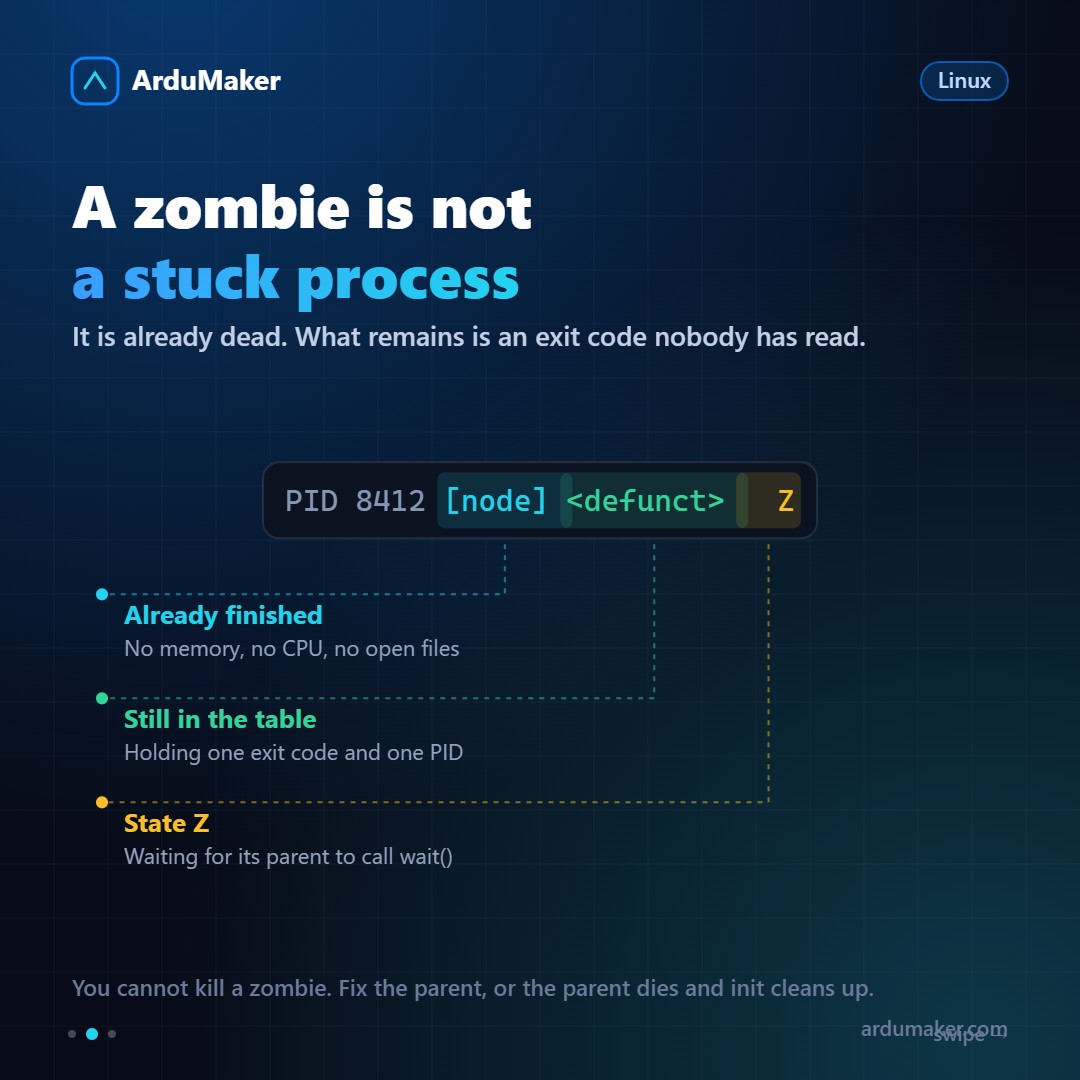
Cuando un proceso termina, no desaparece del todo. El kernel guarda una entrada mínima con su código de salida, esperando a que el padre la lea con wait.
Ese estado intermedio es un zombi.
Dos aclaraciones importantes:
Un zombi no consume nada. No tiene memoria, ni CPU, ni archivos abiertos. Es una entrada en una tabla. La única cosa que retiene es su número de identificador.
No se puede matar un zombi. Ya está muerto. Mandarle una señal no hace nada. La forma de eliminarlo es que el padre lea su estado, o que el padre termine.
Entonces, ¿por qué son un problema? Porque si un programa crea muchos hijos y nunca llama a wait, los zombis se acumulan y pueden agotar la tabla de procesos. El síntoma es "no se pueden crear más procesos" con la máquina aparentemente ociosa.
Y la solución nunca es matar los zombis: es arreglar el padre.
Los huérfanos, que son lo contrario
Si el padre termina antes que el hijo, el hijo queda huérfano. El kernel se lo asigna inmediatamente a init (el proceso 1), que está programado para leer el estado de cualquier hijo que termine.
Por eso un huérfano nunca queda zombi: init lo recoge. Es también el mecanismo por el que un proceso se "desprende" para correr en segundo plano de forma permanente.
Por qué PID 1 es especial, y tu contenedor lo sufre
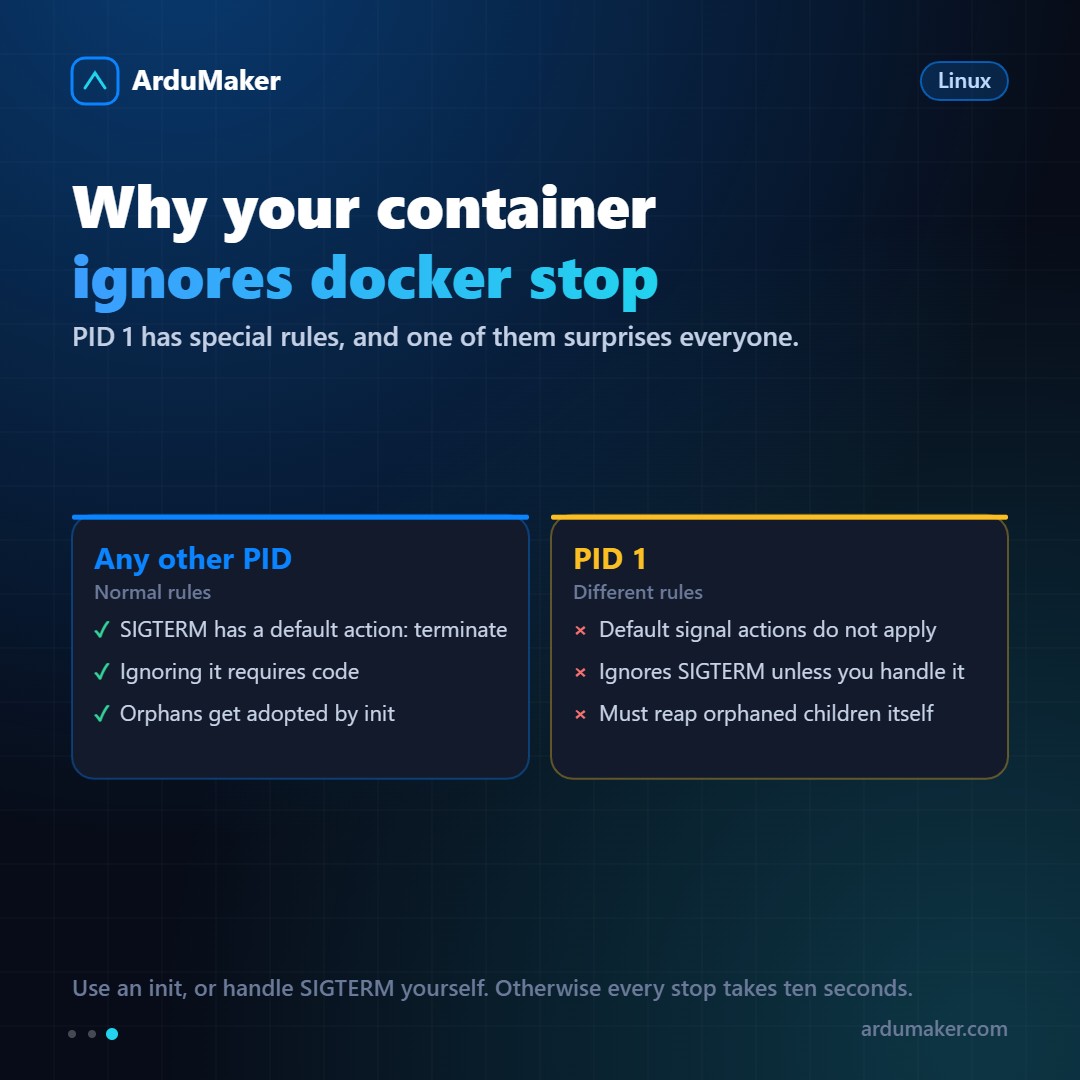
El proceso 1 tiene reglas distintas, y hay una que sorprende a todo el mundo:
Para el proceso 1, las señales no tienen acción por defecto.
Para cualquier otro proceso, recibir la señal de terminación lo termina, aunque su código no haga nada al respecto. Para el proceso 1, si el programa no instaló explícitamente un manejador, la señal se ignora.
Y en un contenedor, tu aplicación suele ser el proceso 1.
Consecuencia práctica: mandás la orden de detener el contenedor, tu aplicación no maneja la señal, no pasa nada. El sistema espera diez segundos y la mata a la fuerza. Por eso cada detención tarda exactamente diez segundos y las conexiones se cortan de golpe.
Dos soluciones:
- Manejar la señal en tu código y cerrar ordenadamente: dejar de aceptar conexiones nuevas, terminar las que están en curso, cerrar la base, salir.
- Usar un init mínimo como proceso 1 (la opción --init de Docker, o tini). Ese init maneja las señales, las reenvía a tu proceso y además recoge los huérfanos.
Es probablemente el detalle de procesos que más impacto tiene en el día a día y menos se explica.